
Chamath Palihapitiya a publié Model Benchmarks Are Worthless, un article fondé sur une étude qu'il a demandé à l'équipe de 8090 Labs de mener. Les classements ne notent que les modèles seuls ; 8090 Labs a donc mesuré le modèle et son harnais ensemble : 7 modèles dans 5 harnais (Codex, Claude Code, OpenCode, Pi et le DeepSeek harness) sur DeepSWE v1.1 de Datacurve, soit 113 corrections de bogues et ajouts de fonctionnalités réels issus de projets open source, avec 2 essais par tâche et des données arrêtées au 27 septembre. Le résultat clé : un même modèle obtient 24 % ou 59 % sur les mêmes 113 tâches selon le harnais qui l'entoure.
L'écart selon le modèle
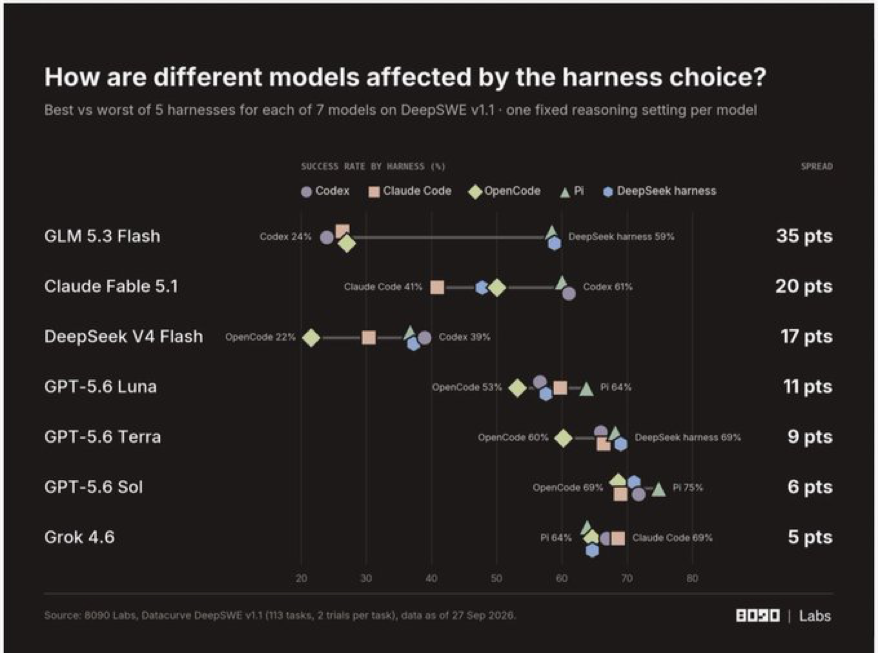 Extrait de l'article de Chamath (8090 Labs, Datacurve DeepSWE v1.1).
Chaque modèle a tourné avec un seul réglage de raisonnement fixe. Le tableau donne son pire et son meilleur harnais.
| Modèle | Pire harnais | Meilleur harnais | Écart (pts) |
|---|---|---|---|
| GLM 5.3 Flash | Codex, 24 % | DeepSeek harness, 59 % | 35 |
| Claude Fable 5.1 | Claude Code, 41 % | Codex, 61 % | 20 |
| DeepSeek V4 Flash | OpenCode, 22 % | Codex, 39 % | 17 |
| GPT-5.6 Luna | OpenCode, 53 % | Pi, 64 % | 11 |
| GPT-5.6 Terra | OpenCode, 60 % | DeepSeek harness, 69 % | 9 |
| GPT-5.6 Sol | OpenCode, 69 % | Pi, 75 % | 6 |
| Grok 4.6 | Pi, 64 % | Claude Code, 69 % | 5 |
GLM 5.3 Flash est le modèle le plus sensible au harnais, avec un écart de 35 points qui équivaut à un taux de réussite multiplié par 2,5 (59 % contre 24 %). Claude Fable 5.1 suit avec 20 points : 41 % dans Claude Code contre 61 % dans Codex, avec une médiane de 28 appels d'outils dans l'un des harnais et de 66 dans l'autre. GPT-5.6 Sol et Grok 4.6 y ont à peine réagi, avec 6 et 5 points.
Aucun harnais ne gagne partout. Codex est le meilleur harnais pour Fable 5.1 et DeepSeek V4 Flash, mais le pire pour GLM 5.3 Flash. Claude Code est le pire pour Fable 5.1 et le meilleur pour Grok 4.6. OpenCode est le pire pour quatre des sept modèles (DeepSeek V4 Flash, Luna, Terra et Sol), tandis que Pi arrive en tête pour Luna et Sol et que le DeepSeek harness arrive en tête pour GLM et Terra.
GLM 5.3 Flash dans cinq harnais
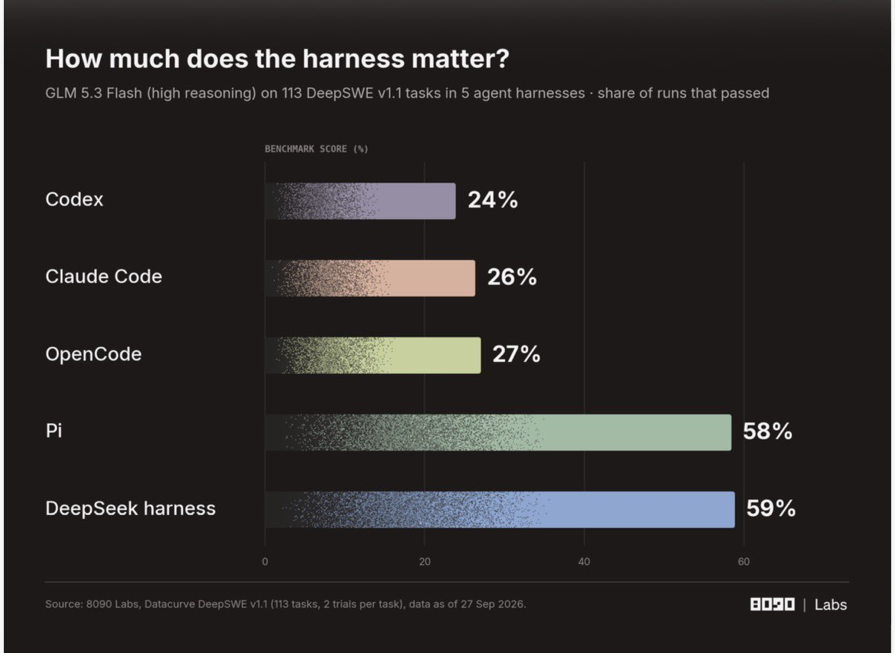 GLM 5.3 Flash (raisonnement high), part des exécutions réussies. Extrait de l'article de Chamath.
Avec le raisonnement high, GLM réussit 24 % des exécutions dans Codex, 26 % dans Claude Code et 27 % dans OpenCode, puis bondit à 58 % dans Pi et 59 % dans le DeepSeek harness. Les harnais se séparent en deux groupes distants de 31 à 35 points, alors que le modèle ne change jamais.
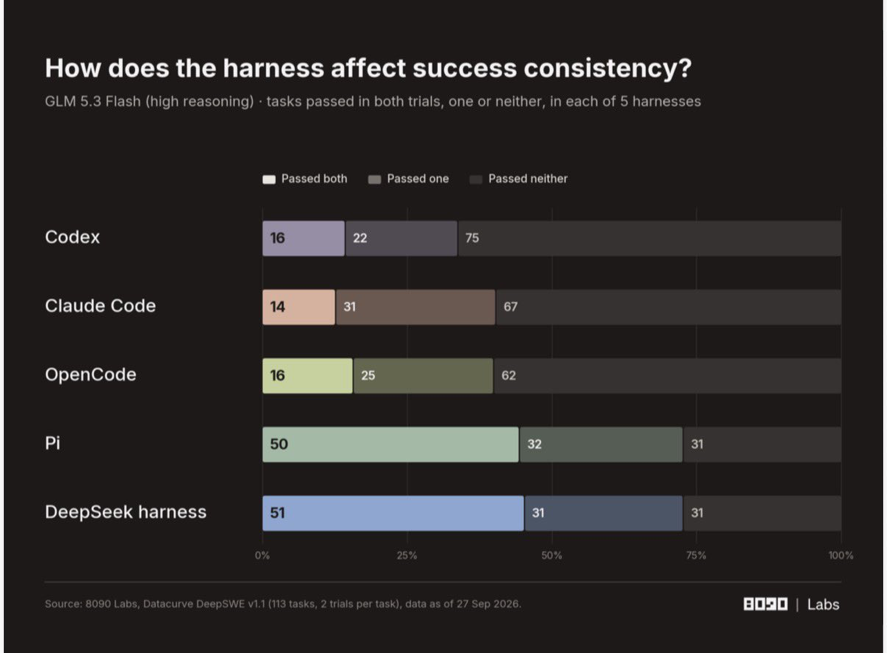 Tâches réussies aux deux essais, à un seul ou à aucun. Extrait de l'article de Chamath.
La régularité suit le même schéma. Les tâches réussies aux deux tentatives sont au nombre de 16 dans Codex, 14 dans Claude Code et 16 dans OpenCode, contre 50 dans Pi et 51 dans le DeepSeek harness. Dans Codex, la répartition sur 113 tâches est de 16 réussies aux deux essais, 22 à un seul et 75 à aucun ; dans Pi, elle est de 50, 32 et 31 ; dans le DeepSeek harness, de 51, 31 et 31.
Ce que coûte une exécution réussie
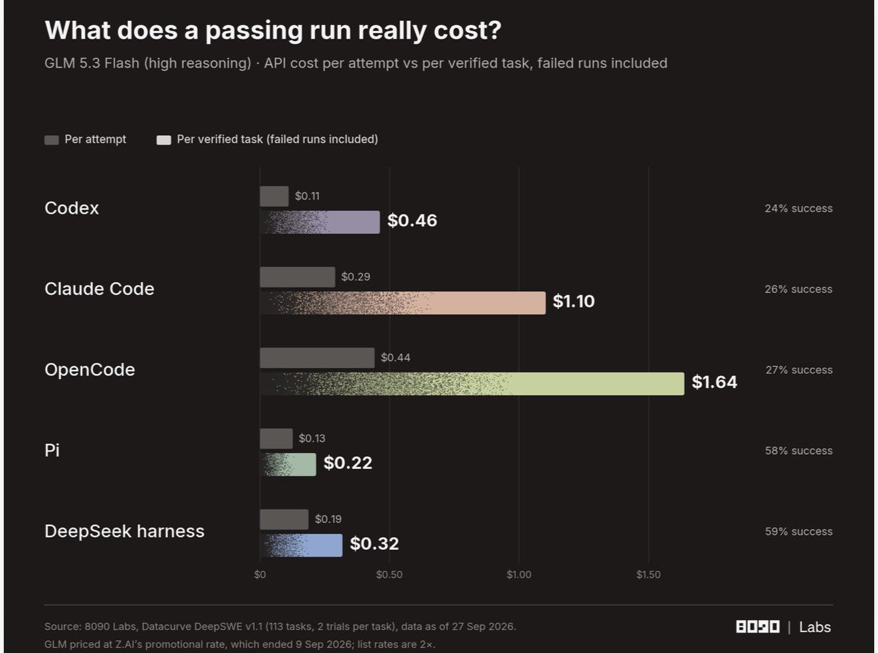 GLM 5.3 Flash (raisonnement high), au tarif promotionnel de Z.AI. Extrait de l'article de Chamath.
Le graphique des coûts valorise GLM au tarif promotionnel de Z.AI, qui a pris fin le 9 septembre ; les tarifs catalogue sont deux fois plus élevés. Une tâche vérifiée inclut le coût des exécutions échouées.
| Harnais | Réussite | Par tentative | Par tâche vérifiée |
|---|---|---|---|
| Codex | 24 % | 0,11 $ | 0,46 $ |
| Claude Code | 26 % | 0,29 $ | 1,10 $ |
| OpenCode | 27 % | 0,44 $ | 1,64 $ |
| Pi | 58 % | 0,13 $ | 0,22 $ |
| DeepSeek harness | 59 % | 0,19 $ | 0,32 $ |
Le texte de Chamath cite les mêmes mesures aux prix catalogue : Codex coûte 0,22 $ par exécution et 0,93 $ par réussite, Pi 0,25 $ par exécution et 0,43 $ par réussite. C'est exactement le double du graphique (0,11 $ devient 0,22 $, 0,46 $ devient environ 0,93 $, 0,13 $ devient environ 0,25 $ et 0,22 $ devient environ 0,43 $).
Les rapports se maintiennent aux deux tarifs. Pi coûte légèrement plus cher par tentative que Codex (0,13 $ contre 0,11 $ en promotion, 0,25 $ contre 0,22 $ au prix catalogue) mais revient environ 2,1 fois moins cher par tâche vérifiée (0,22 $ contre 0,46 $, ou 0,43 $ contre 0,93 $ au prix catalogue). OpenCode coûte environ 7,5 fois plus que Pi par tâche vérifiée sur le graphique (1,64 $ contre 0,22 $). Des tentatives bon marché qui échouent le plus souvent ne font pas un travail bon marché.
La conclusion de Chamath
Chamath écrit qu'il ignore de plus en plus les résultats des classements limités aux modèles, en partie par lassitude et en partie parce qu'une progression dans un classement ne se retrouve pas dans le travail réel. Sa conclusion : choisir une combinaison de modèle et de harnais à partir d'un classement limité aux modèles revient à prendre une décision critique avec la moitié de l'information.
Contexte sur ce blog :
- DeepSeek Harness : le harnais open source qui domine le graphique des scores de GLM ici.
- Le lancement de Muse Wonder par Meta : DeepSWE 1.1 y figure comme ligne de programmation à long horizon de son tableau de benchmarks.
- Claude Fable 5.1 et Mythos 5.1 : le modèle qui passe de 41 % à 61 % d'un harnais à l'autre.
- GPT-6 Sol et Luna : les successeurs de GPT-5.6 Sol et Luna mesurés ici.