
Mark Zuckerberg a présenté Muse Wonder comme « notre nouvelle famille de modèles de pointe, avec des performances à l'état de l'art pour le travail agentique personnel et professionnel ». Alexandr Wang, de Meta, l'a qualifié de « meilleur modèle au monde pour les agents personnels et les agents professionnels », ajoutant que Meta l'a évalué face aux meilleurs modèles du monde sur des tâches agentiques et de code et que « nous pensons que vous allez tous l'aimer ». La famille compte deux variantes, Muse Wonder Full et Muse Wonder.
Les benchmarks
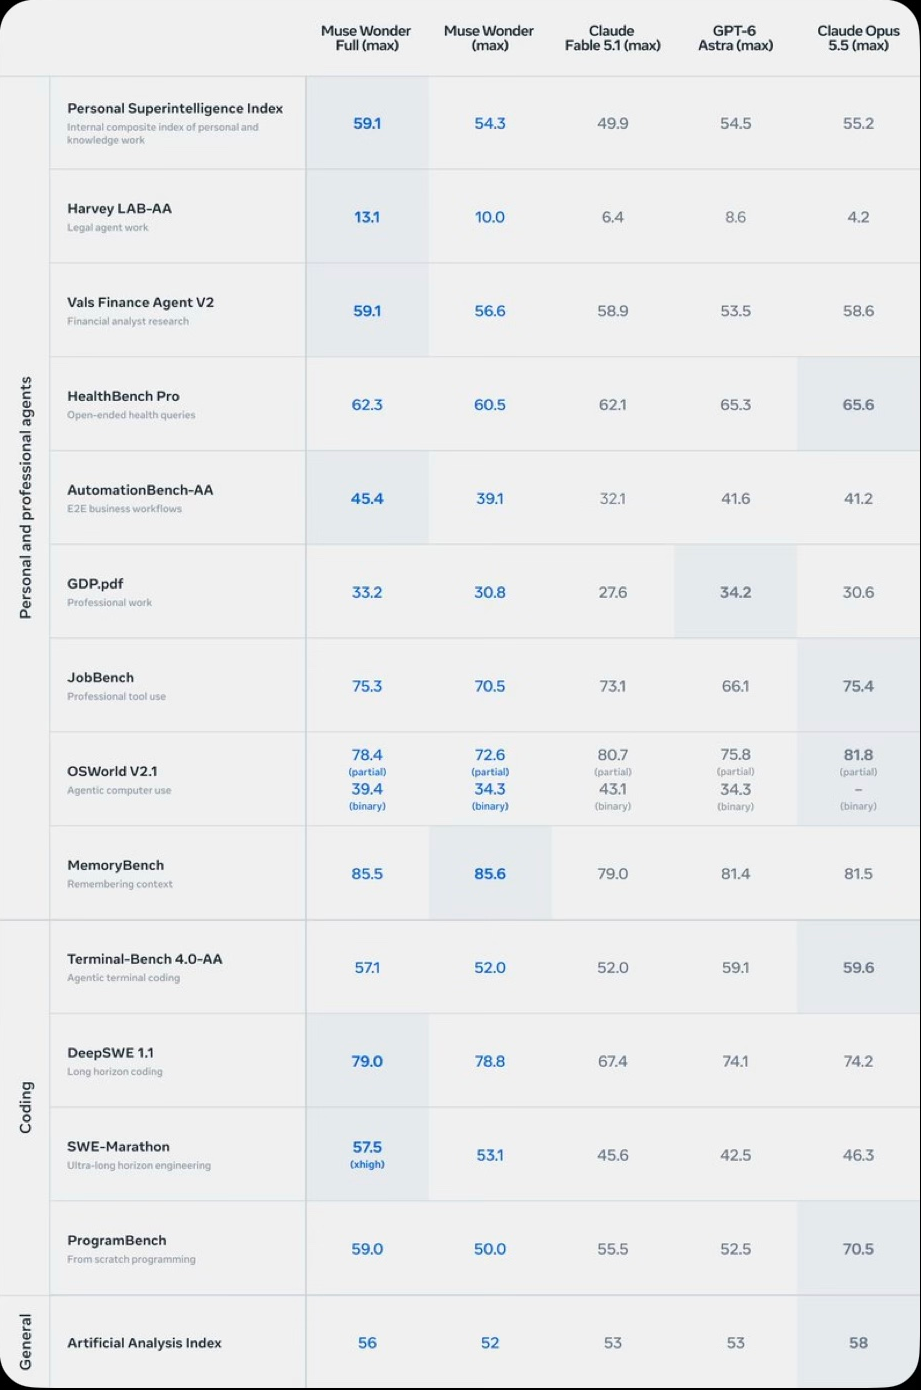 Tiré de l'annonce de Mark Zuckerberg.
Tous les modèles tournent à leur niveau d'effort le plus élevé (max), sauf Muse Wonder Full sur SWE-Marathon, qui tourne en xhigh. Le meilleur score de chaque ligne est en gras.
| Groupe | Benchmark | Muse Wonder Full | Muse Wonder | Claude Opus 5.5 | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|---|---|---|---|
| Agents personnels et professionnels | Personal Superintelligence Index | 59,1 | 54,3 | 55,2 | 54,5 | 49,9 |
| Agents personnels et professionnels | Harvey LAB-AA (travail d'agent juridique) | 13,1 | 10,0 | 4,2 | 8,6 | 6,4 |
| Agents personnels et professionnels | Vals Finance Agent V2 (recherche d'analyste financier) | 59,1 | 56,6 | 58,6 | 53,5 | 58,9 |
| Agents personnels et professionnels | HealthBench Pro (questions de santé ouvertes) | 62,3 | 60,5 | 65,6 | 65,3 | 62,1 |
| Agents personnels et professionnels | AutomationBench-AA (flux de travail métier de bout en bout) | 45,4 | 39,1 | 41,2 | 41,6 | 32,1 |
| Agents personnels et professionnels | GDP.pdf (travail professionnel) | 33,2 | 30,8 | 30,6 | 34,2 | 27,6 |
| Agents personnels et professionnels | JobBench (usage d'outils professionnels) | 75,3 | 70,5 | 75,4 | 66,1 | 73,1 |
| Agents personnels et professionnels | OSWorld V2.1 (usage agentique de l'ordinateur), crédit partiel | 78,4 | 72,6 | 81,8 | 75,8 | 80,7 |
| Agents personnels et professionnels | OSWorld V2.1, binaire | 39,4 | 34,3 | – | 34,3 | 43,1 |
| Agents personnels et professionnels | MemoryBench (mémorisation du contexte) | 85,5 | 85,6 | 81,5 | 81,4 | 79,0 |
| Code | Terminal-Bench 4.0-AA (code agentique en terminal) | 57,1 | 52,0 | 59,6 | 59,1 | 52,0 |
| Code | DeepSWE 1.1 (code sur longue durée) | 79,0 | 78,8 | 74,2 | 74,1 | 67,4 |
| Code | SWE-Marathon (ingénierie sur très longue durée) | 57,5 | 53,1 | 46,3 | 42,5 | 45,6 |
| Code | ProgramBench (programmation à partir de zéro) | 59,0 | 50,0 | 70,5 | 52,5 | 55,5 |
| Général | Artificial Analysis Index | 56 | 52 | 58 | 53 | 53 |
En comptant OSWorld V2.1 une seule fois, sur le crédit partiel, un modèle Muse Wonder obtient le meilleur score sur 7 des 14 lignes : Muse Wonder Full sur six et Muse Wonder sur MemoryBench. Claude Opus 5.5 en domine six, GPT-6 Astra une, et Claude Fable 5.1 aucune, bien qu'il affiche le meilleur chiffre binaire d'OSWorld (43,1).
Les plus larges avances de Muse Wonder Full portent sur SWE-Marathon (+11,2 sur Opus 5.5, avec un niveau d'effort inférieur au max de ses rivaux), DeepSWE (+4,8 sur Opus 5.5), Harvey LAB-AA (+4,5 sur Astra), le Personal Superintelligence Index (+3,9 sur Opus 5.5) et AutomationBench-AA (+3,8 sur Astra). Sur Vals Finance Agent V2, il devance Fable 5.1 de 0,2. L'Index est décrit comme un indice composite interne du travail personnel et du travail de connaissance.
Opus 5.5 devance Full sur ProgramBench de 11,5 (70,5 contre 59,0), sur OSWorld V2.1 en crédit partiel de 3,4, sur HealthBench Pro de 3,3, sur Terminal-Bench 4.0-AA de 2,5, sur l'Artificial Analysis Index de 2 points (58 contre 56) et sur JobBench de 0,1. Astra devance Full sur GDP.pdf de 1,0. Le schéma est le suivant : Full domine le code sur longue durée et les lignes d'agents et de travail de connaissance, tandis qu'Opus 5.5 garde la programmation à partir de zéro, l'usage de l'ordinateur et la santé.
Les lignes se répartissent en trois groupes : agents personnels et professionnels (neuf benchmarks, OSWorld V2.1 étant noté de deux façons), code (quatre) et général (un). Full obtient un score supérieur à celui du Muse Wonder standard sur 13 des 14 lignes. Le Muse Wonder standard domine MemoryBench avec 85,6, soit 0,1 de plus que Full, et se classe deuxième sur cinq sur SWE-Marathon (53,1) et DeepSWE (78,8, à 0,2 de Full).
Contexte
Muse Wonder succède à Muse Spark 1.3, le précédent modèle de Meta, sorti le 3 septembre, et à l'agent personnel Muse que Meta a lancé le 9 septembre.
Les modèles de comparaison sont Claude Opus 5.5, lancé le 22 septembre, et GPT-6 Astra, sorti le 3 septembre, ainsi que Claude Fable 5.1, qui ne domine aucune ligne.