
L'équipe MiMo de Xiaomi a annoncé MiMo-V2.6 : deux modèles omnimodaux à poids ouverts, Pro et Flash, ainsi qu'un mode d'inférence UltraSpeed pour Pro. Le fil de lancement met en avant une affirmation précise : « Pro se situe au niveau de Claude Opus 5 et de GPT-5.6 Sol sur la plupart des benchmarks d'agents. » Le tableau comparatif du propre rapport technique, et la lecture indépendante d'Artificial Analysis du modèle publiée le lendemain, méritent tous deux d'être confrontés à cette phrase.
« Au niveau » regroupe deux affirmations distinctes, et une seule tient
Le tableau 3 du rapport technique liste 17 benchmarks, avec des scores pour Opus 5 et Sol rapportés respectivement sur 14 et 15 d'entre eux. En comparant MiMo-V2.6-Pro à chaque nom séparément, plutôt qu'au bloc « Opus 5 et Sol » :
Face à Claude Opus 5 : Pro gagne sur 3 (AutomationBench, Terminal Bench 2.1, MiMo Visual Coding), fait match nul sur 1 (Agents' Last Exam, 31,6 partout), et perd sur 10 — dont un écart de 35 points sur GDPval-AA 2.1, de 14,1 points sur Terminal Bench 4.0, et de 22,1 points sur ExploitBench (47,9 contre 70,0). Un bilan de 3 victoires, 10 défaites et 1 nul n'est pas une parité selon une lecture raisonnable.
Face à GPT-5.6 Sol : Pro gagne sur 8 et perd sur 7, dont un écart de 30,6 points sur ExploitBench — réellement proche d'un partage. La moitié « au niveau de Sol » de l'affirmation résiste à l'examen des propres chiffres de Xiaomi ; la moitié « au niveau d'Opus 5 », non.
L'ensemble de comparaison a aussi une génération de retard sur la propre page marketing de Xiaomi
Opus 5 et Sol ne sont plus la frontière actuelle. Claude Fable 5.1 et GPT-6 Astra ont tous deux été lancés trois semaines avant cette sortie et supplantaient déjà les modèles du tableau 3 — aucun des deux n'apparaît dans le tableau comparatif du rapport technique. Ils apparaissent, sélectivement, sur la page marketing de Xiaomi, et là où ils figurent le tableau se dégrade pour MiMo-Pro : Terminal Bench 4.0 (Astra 59,6, Fable 5.1 55,1, Pro 34,9), ExploitGym (Astra 42,4 contre Pro 17,8), et MiMo Visual Coding, le benchmark interne de Xiaomi lui-même (Astra 82,2, Fable 5.1 74,4, Pro 72,3). Pro bat bien Astra sur MiMo Code Bench, AutomationBench et GDPval-AA 2.1, ce n'est donc pas un balayage total non plus — mais les catégories qui ressemblent le plus à une exécution agentique réelle sont précisément celles où les deux modèles actuellement à la frontière prennent le plus d'avance, et précisément les deux modèles que le tableau du rapport technique omet.
Le chiffre DeepSWE manque la seule précision qui le rendrait vérifiable
La fiche technique officielle de V4.1 Flash publiée par DeepSeek a fait tourner le même benchmark — DeepSWE v1.1 — sur huit harnais différents et trouvé un écart de 8,7 points, le chiffre utilisé pour affirmer qu'il « dépassait » Opus 5 se révélant être le score du harnais le plus favorable des huit. Le score de 71,9 de MiMo-V2.6-Pro sur ce même benchmark n'est accompagné d'aucune précision de harnais, ce qui compte davantage ici que pour la plupart des laboratoires : l'évaluation d'ASI-Bench avait déjà mesuré le score de MiMo-V2.5-Pro passer de 16,17 à 23,25 par le seul changement de harnais. Un modèle déjà démontré sensible au harnais, sur un benchmark déjà démontré variant de 8,7 points selon le harnais, rapporté sans préciser lequel a produit le chiffre, n'est actuellement pas vérifiable comme l'a été la propre divulgation de DeepSeek.
Le cadrage RSI ne comporte aucune réserve
La deuxième phrase du billet de lancement — « Cela marque une étape clé dans notre exploration de la voie de la RSI : passer à l'échelle le calcul de RL sur des tâches vérifiables et complexes, afin que le modèle puisse continuellement élargir sa frontière de capacités » — est tout le traitement que reçoit l'auto-amélioration récursive. Aucun langage de sécurité, aucune déclaration de bornes, aucun « nous en sommes au début ». Le rapport RSI d'OpenAI déclare ne pas « encore savoir comment atteindre en toute sécurité la RSI complète et alignée ». L'essai de Z.ai affirme explicitement que « choisir les objectifs, fixer les limites et évaluer les risques restent des responsabilités humaines ». Même l'annonce AIRA₃ de Meta, la moins réservée des trois, ouvre par « nous en sommes au début, et des problèmes difficiles restent devant nous » avant d'employer le terme. Parmi quatre laboratoires désormais recensés utilisant ce terme ce mois-ci, Xiaomi est le seul sans aucun langage de sécurité.
Le mécanisme d'UltraSpeed est réel ; son affirmation de qualité ne l'est pas
L'affirmation « jusqu'à 20 fois plus rapide... à qualité égale » n'est pas une boîte noire — Xiaomi l'a documentée comme un décodage spéculatif DFlash (prédiction parallèle masquée par blocs) combiné à une quantification FP4 sélective des matrices d'experts du MoE, en conservant routeurs et attention à plus haute précision. Un mécanisme réel et nommé. Ce qui manque, c'est une ligne de benchmark pour UltraSpeed lui-même à côté de Pro standard — quantifier les poids du MoE en 4 bits est une source bien étudiée de perte de qualité mesurable même avec un entraînement conscient de la quantification, et « à qualité égale » n'est vérifié nulle part dans ce qui est publié.
Le chiffre de coût du RL est celui de la campagne d'entraînement, pas du modèle
Xiaomi rapporte que la phase de RL a achevé 30 étapes sur environ 750 000 trajectoires en moins de six jours, pour environ 0,85 million de dollars pour Flash et 2,62 millions pour Pro — un total combiné de 3,47 millions de dollars, déjà repris dans certaines couvertures titrées autour de ce chiffre. Il s'agit spécifiquement de la phase de RL divulguée, pas du pré-entraînement ni du calcul sous-jacent des points de contrôle de base. La campagne de Flash a coûté moins d'un tiers de celle de Pro et a produit le gain relatif le plus important, la forme attendue pour un modèle disposant de plus de marge de progression. Diffuser la campagne en direct sur six jours est une pratique de transparence que ce blog n'a vue chez aucun autre laboratoire cette année, à saluer même sans moyen de confirmer à quel point ce flux a été continu.
Le cas de co-conception d'un matériau MOF et la formalisation en Lean 4 du théorème de Li et Yorke que Xiaomi met en avant sont chacun un exemple unique travaillé, pas une évaluation chiffrée — couvert plus en détail séparément, avec ce qui a réellement été vérifié physiquement de l'affirmation sur le MOF (pas grand-chose).
Où cela se situe réellement : les propres chiffres d'Artificial Analysis
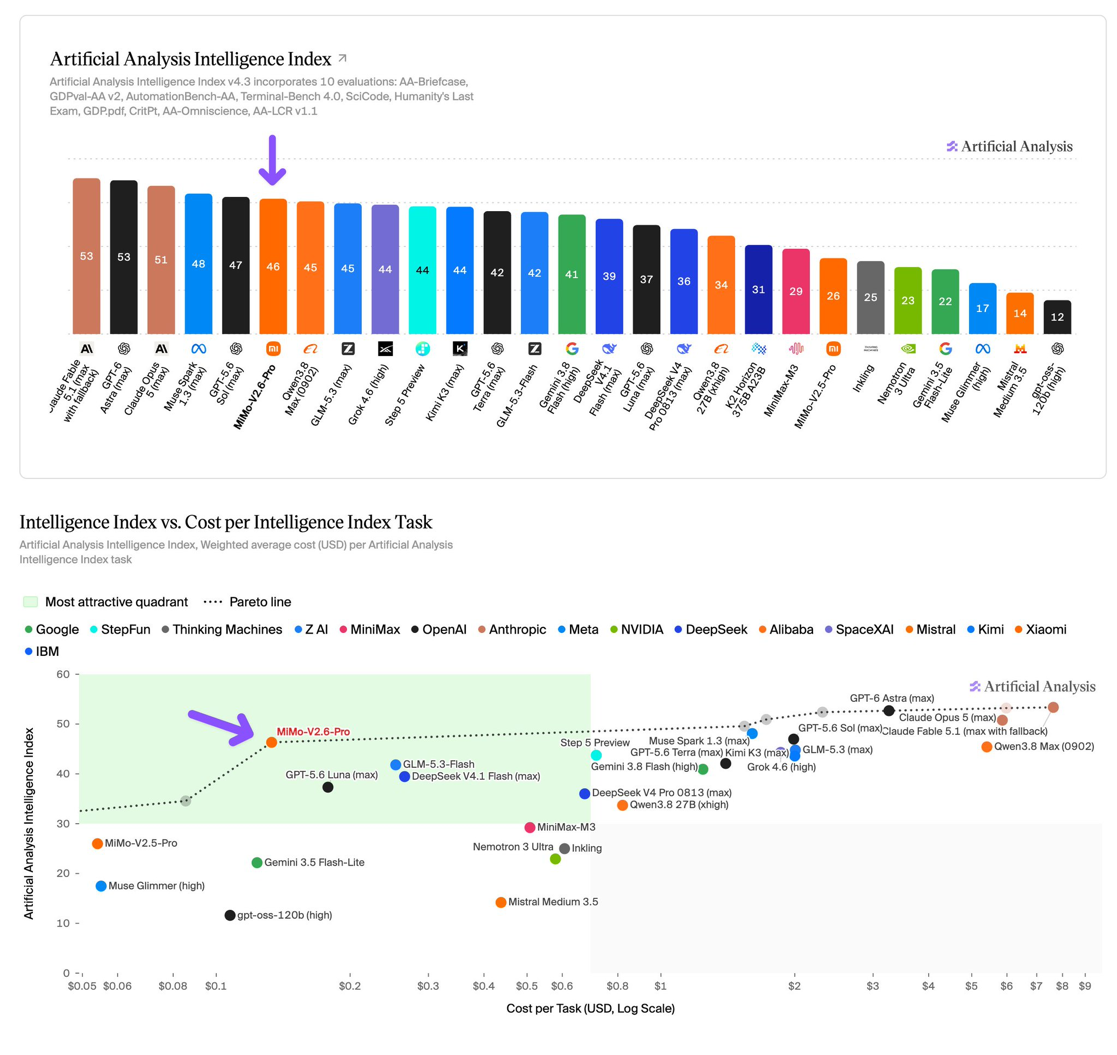 Les propres graphiques d'Artificial Analysis, publiés le lendemain du lancement.
Le diagramme à barres d'AA place MiMo-V2.6-Pro à 46 sur l'Intelligence Index (v4.3) — chaque modèle le devançant (Fable 5.1, Astra, Opus 5, Muse Spark 1.3, Sol) est fermé, et les deux rivaux à poids ouverts les plus proches, Qwen3.8 Max et Kimi K3, accusent un et deux points de retard. « Le modèle open source le plus performant à ce jour » résiste à l'examen des propres chiffres d'AA, pas seulement à ceux de Xiaomi. AA indique aussi que le modèle compte 1,02 billion de paramètres au total, 42 milliards actifs, et le tarife à 0,435 par million de jetons — une position sur la frontière de Pareto qui pèse plus lourd que la plupart des affirmations de Pareto auto-tracées, précisément parce qu'un tiers l'a tracée.
L'indice explique aussi l'écart avec Opus 5 mentionné plus haut. Trois de ses dix composantes (GDPval-AA, AutomationBench, Terminal Bench 4.0) recoupent de près des lignes du tableau 3 où Pro perdait largement face à Opus 5 — pourtant l'écart composite complet sur les dix composantes reste contenu à 5 points (46 contre 51), pas l'écart plus large que ces défaites précises suggéreraient seules. Les sept autres composantes font un vrai travail de resserrement. La position réelle de MiMo-V2.6-Pro n'est ni « au niveau d'Opus 5 » ni « très en retard » — c'est un modèle qui perd du terrain sur un sous-ensemble de tâches d'exécution agentique et le regagne pour l'essentiel ailleurs.
Un point en suspens : une seconde version, différemment présentée, de ce graphique de frontière circule, attribuant chaque point aux « données de benchmark publiques d'Artificial Analysis » sauf celui de MiMo-V2.6-Pro, sourcé séparément à « Xiaomi MiMo ». Pris littéralement, cela signifierait qu'AA n'a pas testé le modèle de façon indépendante et relaie le chiffre de Xiaomi. À l'inverse, la couverture de Muse Spark 1.3 par ce blog avait déjà établi qu'AA marque un score réellement non vérifié comme « non actuellement disponible » plutôt que de publier un chiffre — et l'entrée de MiMo-V2.6-Pro sur le graphique d'AA a reçu une barre précise, pas cette mention. La lecture la plus probable est que le chiffre d'AA est réel ; la note de bas de page du second graphique, provenant d'une source non identifiable ici, est une complication à signaler plutôt qu'à trancher.
MiMo-V2.5 a été publié sous licence MIT ; si V2.6 suit ce précédent — les propres documents de Xiaomi n'énoncent pas les conditions explicitement —, il rejoint les 81 % des grandes sorties chinoises à poids ouverts que ce blog a déjà trouvées sous conditions Apache ou MIT.