
Google DeepMind a présenté Gemini 4 Argon le 30 septembre 2026, le qualifiant de nouveau modèle de frontière, « conçu pour les flux de travail complexes en codage, en travail de connaissance en entreprise et en défense cybersécurité ». Il est déployé auprès de testeurs de confiance et de défenseurs cyber via le programme Fairwind de Google. Dans le tableau de 19 benchmarks de Google lui-même, Argon obtient le meilleur score, ou un score à égalité, sur 14 lignes (le meilleur score sans égalité sur 13). Il est comparé à GPT-6 Astra, Claude Fable 5.1 et Claude Opus 5.5, tous disponibles publiquement.
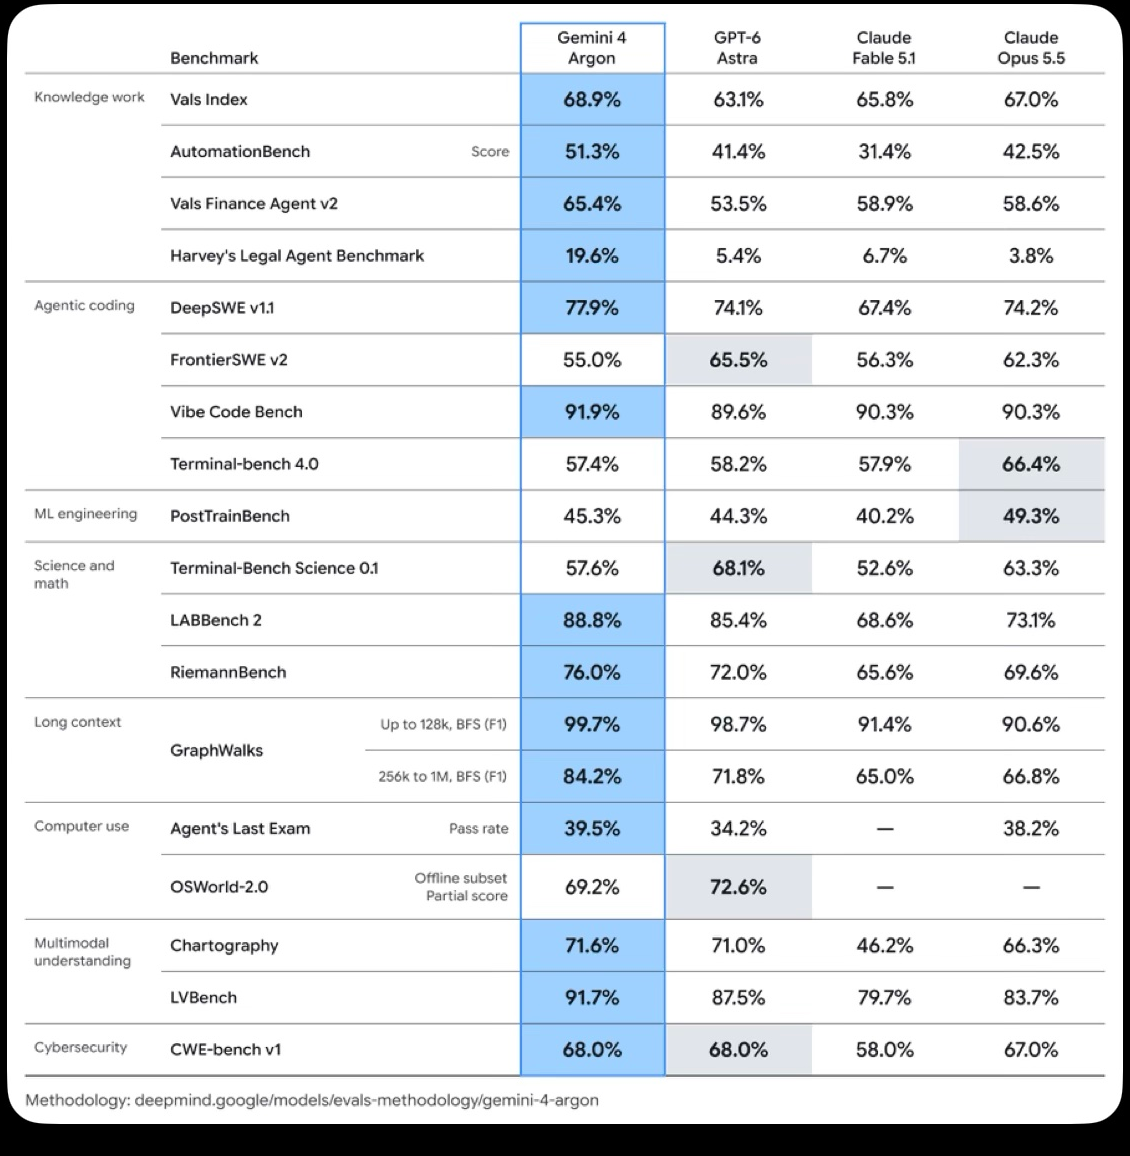 Tableau de benchmarks extrait de l'annonce de Gemini 4 Argon par Google DeepMind.
Déjà à l'œuvre chez Google
Google indique que des milliers de Googlers utilisent déjà Argon pour du code, de la recherche et de la rédaction spécialisés. Quelques exemples :
- Algorithmes quantiques : Argon a optimisé les ressources d'espace-temps (qubits × portes) de sous-routines goulots d'étranglement, battant de 40 % la référence publiée dans un cas.
- Mémoire : des agents Argon ont analysé la télémétrie de profilage à l'échelle de toute la flotte et appliqué des optimisations dans les centres de données de Google, libérant plus de 300 TiB (de 500 TiB à 1 PiB au total, selon les estimations).
- Migrations vers Rust : des agents migrent du C/C++ vers Rust, de dizaines de milliers de lignes dans des bibliothèques comme re2 et libgav1 jusqu'à plus de 800 000 lignes pour le noyau Fuchsia Zircon. Ces réécritures sont en cours d'audit et de revue avant la mise en production.
- libgav1 : des agents ont remplacé 32 000 lignes de code SIMD dans un portage Rust existant, produisant un décodeur vidéo à sécurité mémoire qui tourne 2,7 fois plus vite que le portage, avec une sortie identique.
Là où il domine
Google met en avant l'état de l'art sur DeepSWE v1.1 (77,9 %), la première place sur le Vals Index, Vals Finance Agent v2 et le Legal Agent Benchmark de Harvey, la première place sur AutomationBench de Zapier (51,3 %) et l'état de l'art sur LVBench (91,7 %). Sa limite de sortie passe à 1 million de jetons, contre 64 000 auparavant.
Les plus grands écarts se trouvent dans le travail de connaissance et le long contexte. Sur AutomationBench, Astra obtient 41,4 %, Fable 5.1 31,4 % et Opus 5.5 42,5 %. Sur le benchmark de Harvey, Argon obtient 19,6 % contre 5,4 %, 6,7 % et 3,8 %. Il mène Vals Finance Agent v2 avec 65,4 % (le meilleur suivant : 58,9 %) et le Vals Index avec 68,9 % (Opus : 67,0 %). Sur GraphWalks à 256k–1M de jetons, il atteint 84,2 F1 contre 71,8, 65,0 et 66,8.
Il mène aussi LABBench 2 (88,8 %), RiemannBench (76,0 %), Chartography (71,6 %) et Vibe Code Bench (91,9 %). Sur CWE-bench v1, Argon est à égalité avec Astra pour la première place à 68,0 %, devant Fable 5.1 (58,0 %) et Opus 5.5 (67,0 %).
Face à chaque rival, en ne comptant que les lignes où le rival a un score :
- GPT-6 Astra : 14 victoires, 4 défaites, 1 égalité sur 19 lignes.
- Claude Fable 5.1 : 15 victoires, 2 défaites sur 17 lignes.
- Claude Opus 5.5 : 14 victoires, 4 défaites sur 18 lignes.
Là où il est en retrait
Le codage agentique est le principal point faible, OSWorld-2.0 restant aussi derrière Astra. Argon est 10,5 points derrière Astra sur FrontierSWE v2 et 9,0 derrière Opus 5.5 sur Terminal-bench 4.0, et Fable 5.1 le devance aussi sur les deux. Les cinq lignes où un autre modèle est en tête :
| Benchmark | Gemini 4 Argon | En tête | Score du leader |
|---|---|---|---|
| FrontierSWE v2 | 55,0 % | GPT-6 Astra | 65,5 % |
| Terminal-bench 4.0 | 57,4 % | Claude Opus 5.5 | 66,4 % |
| PostTrainBench | 45,3 % | Claude Opus 5.5 | 49,3 % |
| Terminal-Bench Science 0.1 | 57,6 % | GPT-6 Astra | 68,1 % |
| OSWorld-2.0 (sous-ensemble hors ligne, score partiel) | 69,2 % | GPT-6 Astra | 72,6 % |
Fable 5.1 et Opus 5.5 n'ont pas de score OSWorld-2.0 publié. Bloomberg a rapporté que certains employés de Google estiment que Gemini 4 se comporte bien sur les benchmarks mais peine sur certaines tâches de code en conditions réelles ; Google conteste.
Défense cyber et garde-fous
Google a entraîné Argon à trouver, valider et corriger de façon autonome des vulnérabilités critiques. Les défenseurs de confiance et les équipes internes de Google l'obtiennent sans garde-fous cyber. Wiz, dans le cadre de son initiative Scan for Good, a utilisé Argon pour mettre au jour une vulnérabilité critique exposant des informations personnelles sensibles dans un logiciel de santé utilisé par des hôpitaux du monde entier, un risque que les précédents modèles de frontière avaient manqué. Argon surpasse également Gemini 3.8 Flash Cyber sur le benchmark interne de vulnérabilités de Google, qui couvre 20 langages de programmation, et sur le benchmark de tests d'intrusion en boîte noire de Wiz.
Google décrit quatre domaines de garde-fous :
- Usage malveillant : refus des requêtes cyber et CBRN nuisibles, plus surveillance des activations internes du modèle, testées par des équipes red team internes et externes.
- Injection de prompt : Argon est le modèle de Google le plus résistant à ce jour face à l'injection de prompt indirecte et mène le benchmark IPI de Gray Swan.
- Désalignement : la surveillance de la chaîne de raisonnement et des actions peut interrompre l'exécution. Un système similaire a surveillé les entraînements, avec des constats tenus hors de l'entraînement pour ne pas apprendre au modèle à échapper à la surveillance. Google exhorte l'industrie à préserver la transparence du raisonnement.
- Durcissement : les bacs à sable sont isolés et scellés avant les entraînements ou évaluations à haut risque.
Accès
Fairwind a été lancé le 2 septembre, en même temps que Gemini 3.8 Flash Cyber et le harnais CodeMender. Le programme est ouvert aux autorités gouvernementales de confiance, aux exploitants d'infrastructures critiques et aux mainteneurs de logiciels. Anthropic limite de façon similaire Claude Mythos 5.1 à des organisations vérifiées, comme l'a couvert l'article de ce blog sur Fable 5.1 et Mythos 5.1 ; ici, le modèle à accès restreint est un modèle de frontière généraliste plutôt qu'une variante cyber.
Le tarif d'introduction est de 2 $ par million de jetons en entrée et 10 $ par million de jetons en sortie, avec une remise de 95 % sur l'entrée mise en cache. Google dit participer au processus volontaire du gouvernement américain d'accès aux modèles avant leur sortie tout en élargissant progressivement l'accès. La disponibilité élargie commence par les clients payants de l'API et les abonnés à Google AI Ultra, sans date de disponibilité générale annoncée.
Le titre de The New Stack résume ainsi : « Gemini 4 Argon is here, it's great, and you can't have it yet » (« Gemini 4 Argon est là, il est excellent, et vous ne pouvez pas l'avoir »).