
Anthropic a lancé Claude Opus 5.5 : premier modèle de la nouvelle famille Claude 5.5, tarifé à 4 par million de jetons contre 5 pour Opus 5, avec des lectures de cache ramenées à 0,20 . L'accroche de lancement : « se situe au niveau de Claude Fable 5.1 sur la plupart des tâches ».
Lisez le tableau réel, et c'est un euphémisme. Opus 5.5 bat Fable 5.1 sur les neuf benchmarks présentés — Terminal-Bench 4.0 (66,4 % contre 55,8 %), FrontierCode v1.1 (54,4 % contre 50,3 %), CursorBench 4.0 (57,8 % contre 51,8 %), GDPval-AA v2.1 (1846 contre 1735), AutomationBench (40,0 % contre 31,4 %), Humanity's Last Exam avec outils (67,7 % contre 65,6 %), Terminal-Bench-Science (58,7 % contre 52,6 %), OSWorld 2.0 (81,8 % contre 80,7 %) et Chartography (89,0 % contre 88,4 %). Neuf sur neuf, à 40 % du prix de Fable 5.1 (4 contre 10 ). « Au niveau de » est la rare affirmation d'éditeur qui est en retrait par rapport à ses propres données plutôt que gonflée.
Les deux défaites du tableau sont accompagnées d'une note qui les explique
Face à GPT-6 Astra spécifiquement, Opus 5.5 perd exactement deux fois : AutomationBench (40,0 % contre 41,4 %) et Terminal-Bench-Science (58,7 % contre 64,6 %) — les deux grisées dans le tableau, les seules lignes marquées ainsi. Les propres notes d'Anthropic adressent les deux directement. Sur les garde-fous en général : « Lorsqu'ils sont intervenus, les tâches de cybersécurité ont été complétées par Claude Opus 4.8, et les tâches de biologie et de développement de LLM de frontière par Claude Opus 5. Cela réduit probablement la performance de Claude Opus 5.5 sur ces benchmarks. » Sur AutomationBench spécifiquement : « Ces exécutions ont été menées sans modèles de repli, si bien que les interventions des garde-fous ont été comptées comme des échecs — ce qui a produit un score inférieur à ce que Claude Opus 5.5 obtiendrait en pratique. »
C'est un niveau inhabituel de bruit de mesure divulgué par l'éditeur lui-même — les seuls benchmarks perdus par Opus 5.5 sont précisément ceux que ses propres notes signalent comme artificiellement tirés vers le bas par la façon dont les interventions de sécurité sont comptabilisées, et non comme de véritables écarts de capacité. À prendre au sérieux avec prudence tout de même : « obtiendrait en pratique » est une affirmation d'Anthropic sur elle-même, sans exécution de contrôle montrée pour l'étayer.
Les notes de reproduction sont un point positif plus modeste mais plus net : Anthropic a refait tourner les classements publics de Terminal-Bench 4.0 et Terminal-Bench-Science pour Claude Opus 5 comme vérification de cohérence, et retombe dans la marge de bruit les deux fois (52,3 % contre 51,8 % publiés ; 29,0 % contre 30,0 %) — un contrôle méthodologique de bonne foi que la plupart des tableaux de lancement omettent.
À son réglage le moins cher, il bat déjà le réglage le plus cher de Sol
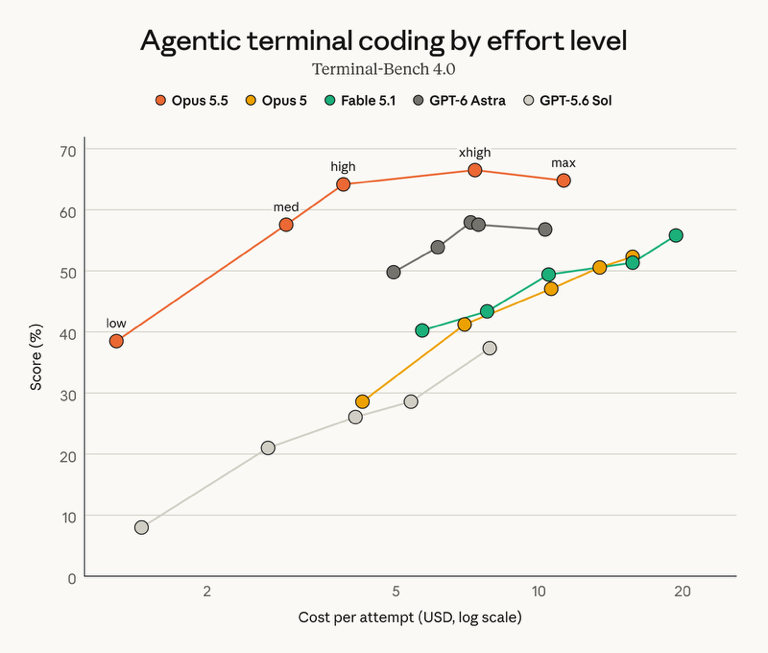 Extrait de la page de lancement d'Opus 5.5 par Anthropic.
La page de lancement d'Anthropic ajoute la ventilation par niveau d'effort derrière le chiffre unique de Terminal-Bench 4.0 mentionné plus haut (xhigh, 66,4 %, cohérent avec ce graphique à l'arrondi près). Le réglage le moins cher d'Opus 5.5 — low, environ 1,30 . Toute la courbe d'Opus 5.5 se situe au-dessus et à gauche de chaque rival, à chaque niveau de coût présenté ; il n'est pas optimal au sens de Pareto en un seul point, il l'est sur l'ensemble de la plage.
« 40 % moins cher à faire tourner » est une moyenne, pas un chiffre unique
Aucune ligne du tableau de prix n'affiche à elle seule une baisse de 40 % : les jetons en entrée baissent de 20 % (5 ), ceux en sortie de 20 % (25 ), les écritures de cache de 20 % (6,25 ) — seules les lectures de cache chutent aussi fort, de 60 % (0,50 ). Le chiffre de 40 % est une estimation moyennée sur un mélange de charges de travail représentatif, le même schéma que ce blog avait relevé lors de la baisse de prix de Fable 5.1 : l'économie réelle sur une charge de travail donnée dépend fortement de son intensité en lectures de cache, et une charge peu mise en cache se rapprochera plutôt de 20 % que de 40 %.