
Anthropic a lancé Claude Sonnet 5.5, deuxième modèle de la famille 5.5 après Opus 5.5. Le prix est inchangé par rapport à Sonnet 5 : 2 par million de jetons, lectures de cache à 0,20 /15 $ en septembre a été annulée en août, selon des sources secondaires ; la page de lancement elle-même dit que Sonnet 5.5 est « au même prix que Sonnet 5 »). Les affirmations du tweet : « une nette amélioration par rapport à Sonnet 5, plus de 30 % plus rapide, et jusqu'à 30 % moins cher pour la plupart des travaux ». x.com est bloqué depuis cet environnement ; les chiffres viennent de la page de lancement : d'abord via un outil de récupération, puis à partir de captures de son tableau de benchmarks et de quatre graphiques de coût par tâche. Les valeurs des graphiques sont lues sur des axes logarithmiques, donc approximatives ; ce sont les rapports qui comptent.
Face à Opus 5.5 : une victoire, sept défaites étroites
| Benchmark | Sonnet 5.5 | Opus 5.5 | Écart |
|---|---|---|---|
| Terminal-Bench 4.0 | 70,6 % | 66,4 % | +4,2 |
| FrontierCode 1.1 | 46,2 % Max / 52,1 % Xhigh | 54,4 % | −8,2 à Max / −2,3 à Xhigh |
| CursorBench 4.0 | 55,5 % | 57,8 % | −2,3 |
| GDPval-AA v2.1 | 1844 | 1846 | −2 Elo |
| AA-Briefcase v1.1 | 1811 | 1822 | −11 Elo |
| Humanity's Last Exam (outils) | 64,5 % | 67,7 % | −3,2 |
| OSWorld 2.1 | 80,1 % | 81,8 % | −1,7 |
| Chartography (sans outils) | 61,6 % | 64,4 % | −2,8 |
La page présente Sonnet 5.5 comme « un complément plus rapide et moins coûteux à Claude Opus 5.5 ». À son meilleur réglage indiqué, aucun écart ne dépasse 3,2 points (11 Elo sur AA-Briefcase) ; l'écart de −8,2 sur FrontierCode est le chiffre à l'effort Max. La note de Terminal-Bench dit que les 66,4 % d'Opus 5.5 sont à xhigh, « le score le plus élevé du modèle ». Le tableau ne dit pas quel effort a produit les 70,6 % de Sonnet. Les graphiques le disent.
« Moitié prix » vaut par jeton ; les graphiques montrent par tâche
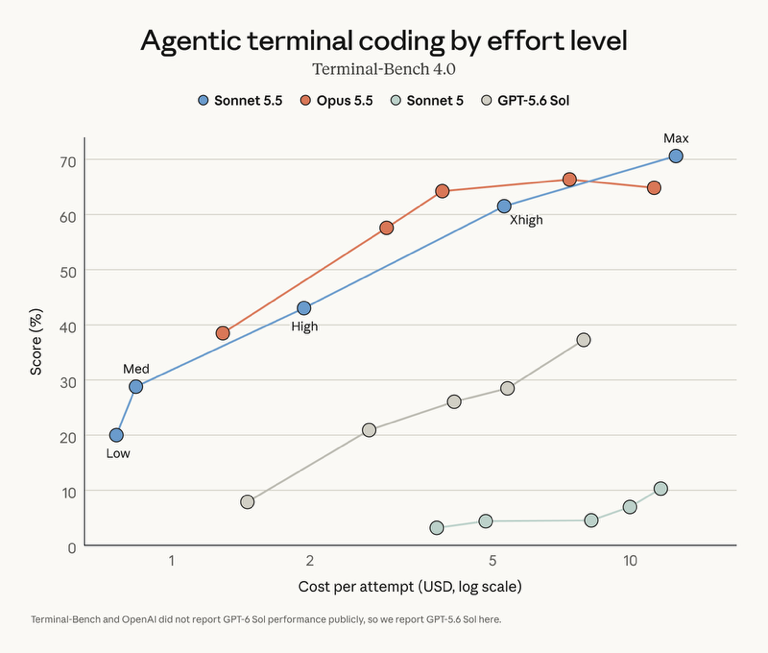 Graphique d'effort Terminal-Bench 4.0, extrait de la page de lancement de Sonnet 5.5 d'Anthropic.
- Terminal-Bench : les 70,6 % de Sonnet 5.5 sont son réglage Max, à environ 13 . La « victoire » coûte donc environ 1,8 fois plus par tentative malgré des jetons à moitié prix, et à tout coût inférieur au point Max de Sonnet, la courbe d'Opus 5.5 est plus haute (Sonnet à Xhigh : environ 61,5 % pour environ 6 : environ 64 %).
- CursorBench : Opus 5.5 atteint environ 56 % pour environ 4 , soit environ 2,4 fois plus pour un score légèrement inférieur. Ce n'est qu'entre les efforts Low et High, jusqu'à environ 1,70 $, que les deux courbes se recoupent ou que Sonnet mène.
- AA-Briefcase : les courbes sont presque confondues jusqu'à Xhigh ; les 1811 de Sonnet à Max coûtent environ 29 .
- FrontierCode : Sonnet 5.5 est fort et bon marché à High (environ 49,5 % pour environ 0,42 ) pour environ un cinquième du coût. Mais Max coûte environ 20 , et Opus 5.5 atteint environ 54,7 % pour environ 0,80 $.
C'est à l'extrémité basse que Sonnet 5.5 mérite vraiment l'affirmation : son réglage Low sur CursorBench (environ 36 % pour environ 0,50 ). Choisissez Sonnet 5.5 à effort Low à High pour le prix. Ses scores à effort maximal sont ceux que le tableau imprime, et ce ne sont pas les moins chers.
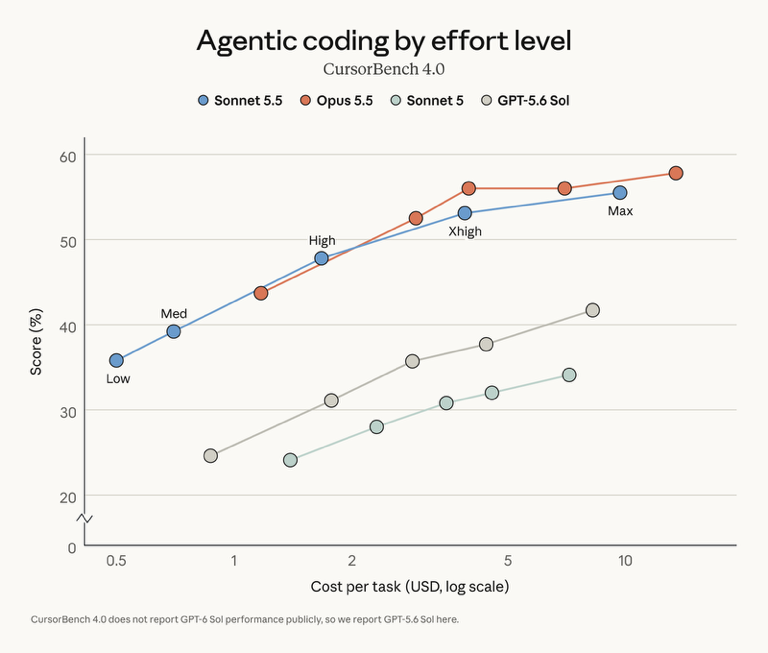 Graphique d'effort CursorBench 4.0, extrait de la page de lancement de Sonnet 5.5 d'Anthropic.
« Nette amélioration » est réel ; « 30 % moins cher » est difficile à situer
Sonnet 5 → 5.5 : Terminal-Bench 10,3 % → 70,6 % (×6,9), Chartography 15,6 % → 61,6 %, OSWorld +23,1 points, CursorBench +21,4. Les graphiques confirment que Sonnet 5 obtient bien un score aussi bas sur Terminal-Bench (3 % à 10 % sur toute sa plage de coût), ce n'est donc pas une coquille du tableau ; le pourquoi n'est pas expliqué.
Sur le coût, la page dit que Sonnet 5.5 « a généralement besoin de bien moins de jetons pour le même travail. Lors de nos tests, il coûte jusqu'à 30 % de moins par tâche ». C'est un plafond issu des propres tests d'Anthropic, et le « jusqu'à 30 % moins cher pour la plupart des travaux » du tweet le transforme en affirmation sur la plupart des travaux. Les graphiques ne le reproduisent dans aucun sens. À libellé d'effort identique, le réglage le plus élevé de Sonnet 5.5 coûte environ 10 % à 2 fois plus par tâche que celui de Sonnet 5 (Terminal-Bench environ 13 , CursorBench environ 9,70 , AA-Briefcase environ 29 ) ; à Low, il coûte beaucoup moins. Les niveaux d'effort sont recalibrés d'un modèle à l'autre, selon les indications API d'Anthropic, donc les comparaisons à libellé identique sont peu fiables, et les 30 % devraient provenir d'une comparaison à qualité égale que la page ne montre pas. Les 30 % de vitesse sont eux aussi relatifs à Sonnet 5 et illustrés par des animations côte à côte, pas par un nombre de jetons par seconde publié.
Les témoignages clients : 12 à 14 % de jetons économisés, plus une valeur aberrante à ×4
Les témoignages de la page de lancement sont les seuls chiffres d'efficacité par client. Slack annonce « 14 % de jetons de sortie en moins » que Sonnet 5, Box « 12 % de jetons au total en moins » (et « 2,4 fois plus rapide »), Lovable « un tiers d'appels d'outils en moins ». Balyasny annonce « 121 k jetons par réponse » contre « 497 k » pour Sonnet 5, soit une baisse de 76 %, bien au-delà du plafond de « jusqu'à 30 % » du texte même de la page. Les deux clients qui donnent des totaux se situent à 12–14 %, bien sous 30 %, et la valeur aberrante est mesurée par réponse, pas par tâche à qualité fixe. Ce sont des citations sollicitées et choisies par le fournisseur : à lire comme des illustrations, pas comme une distribution. Les témoignages de vitesse sont eux aussi mitigés : Zendesk « 20 % plus rapide », Atlassian « jusqu'à 30 % plus rapide » pour ses agents, Box ×2,4.
Les notes de bas de page sont franches, et instructives par ce qu'elles impliquent
- FrontierCode affiche deux scores, et celui mis en avant est le plus bas. Anthropic explique qu'à Max le modèle a trop invoqué une compétence de revue de code qui lançait des sous-agents, causant des délais dépassés ou des modifications hors périmètre « dans deux cas examinés par Cognition ». Divulguer les deux est à son crédit, mais deux cas restent une anecdote, et c'est le même réglage Max qui porte la victoire sur Terminal-Bench à un coût supérieur à celui d'Opus 5.5.
- Artificial Analysis a évalué un déploiement pré-lancement avec un bogue de sorties structurées. Anthropic « s'attend » à ce que l'effet « sous-estime ses performances ». Cette direction est l'attente du fournisseur, non vérifiée.
- Les chiffres de Sol sont peut-être périmés. OpenAI a corrigé un bogue de compréhension d'image dans GPT-6 Sol après la prise de ces scores ; Anthropic dit que ses tests internes suggèrent que Chartography n'a pas été affecté.
- Non comparable d'une page de lancement à l'autre : le tableau d'Opus 5.5 couvert par ce blog donnait Chartography à 89,0 % et OSWorld en « 2.0 » ; ici Chartography est à 64,4 % « sans outils » et OSWorld en « 2.1 » avec un 81,8 % identique.
Face à GPT-6 Sol, au même prix
Sol coûte aussi 2 . Le tableau l'inclut sur quatre lignes sur huit, et Sonnet 5.5 les gagne toutes les quatre : GDPval-AA (1844 contre 1487), AA-Briefcase (1811 contre 1483), Chartography (61,6 % contre 53,6 %) et FrontierCode à Xhigh (52,1 % contre 49,3 % ; le chiffre Max de 46,2 % perdrait). Sur Terminal-Bench, CursorBench, Humanity's Last Exam et OSWorld, le tableau affiche « — ». Les graphiques Terminal-Bench et CursorBench comblent le vide avec GPT-5.6 Sol, le modèle de la génération précédente, avec la note « n'a pas publié publiquement les performances de GPT-6 Sol » : l'avance nette de Sonnet 5.5 y est donc sur le modèle de la génération passée. Sur AA-Briefcase, le tableau des coûts est nuancé : le meilleur score de Sol (1483) coûte environ 2,70 , mais les 1811 de Sonnet coûtent environ dix fois le meilleur de Sol. Astra et Fable 5.1 ne sont comparés nulle part. La page renvoie à une System Card de Sonnet 5.5 pour la méthodologie ; son PDF se trouve sur un domaine CDN inaccessible depuis cet environnement, je ne l'ai donc pas lue.
Migration et garde-fous
thinking: {type: "disabled"} renvoie désormais une erreur 400 sur ce modèle ; la page indique de passer à between_tools. C'est aussi le premier Sonnet avec des garde-fous cyber (les requêtes à haut risque basculent vers Sonnet 5) et des classifieurs destinés à empêcher l'extraction du raisonnement, c'est-à-dire la distillation. Aucune des notes de bas de page que j'ai pu récupérer ne précise si les exécutions avaient les garde-fous activés ni comment les bascules ont été comptées, ce que le tableau d'Opus 5.5 avait, lui, divulgué.