
Google DeepMind a publié EmbeddingGemma 2 le 6 octobre 2026, le présentant comme « notre premier modèle ouvert nativement multimodal pour les embeddings embarqués ». Il étend la famille au-delà du texte pour unifier code, images, audio et vidéo dans un seul espace d'embeddings partagé. Le modèle compte 740 millions de paramètres, est publié sous licence Apache 2.0, et ses poids sont disponibles sur Hugging Face et Kaggle. Les détails figurent dans l'article de lancement de Google.
Un seul espace pour toutes les modalités
Un modèle d'embeddings transforme une entrée en vecteur, de sorte que les sens proches se retrouvent proches les uns des autres. Dans EmbeddingGemma 2, le mot « chat », la photo d'un chat, un extrait audio de chat et une vidéo de chat sont censés se regrouper par sens, quel que soit le format.
Cela rend possibles des recherches intermodales sans modèle distinct par format. L'exemple de Google : retrouver des moments dans une vidéo à partir d'un mémo vocal. Plus généralement, les développeurs peuvent ajouter une recherche multimodale à une application, ou associer le modèle à Gemma 4 pour une génération augmentée par récupération (RAG) privée et embarquée. DiffusionGemma de Google est un autre modèle ouvert bâti sur un socle Gemma 4.
Ce que montrent les trois graphiques
Le fil de Google trace le score moyen en fonction de la taille du modèle sur trois benchmarks, avec une ligne pointillée marquant la frontière taille-score.
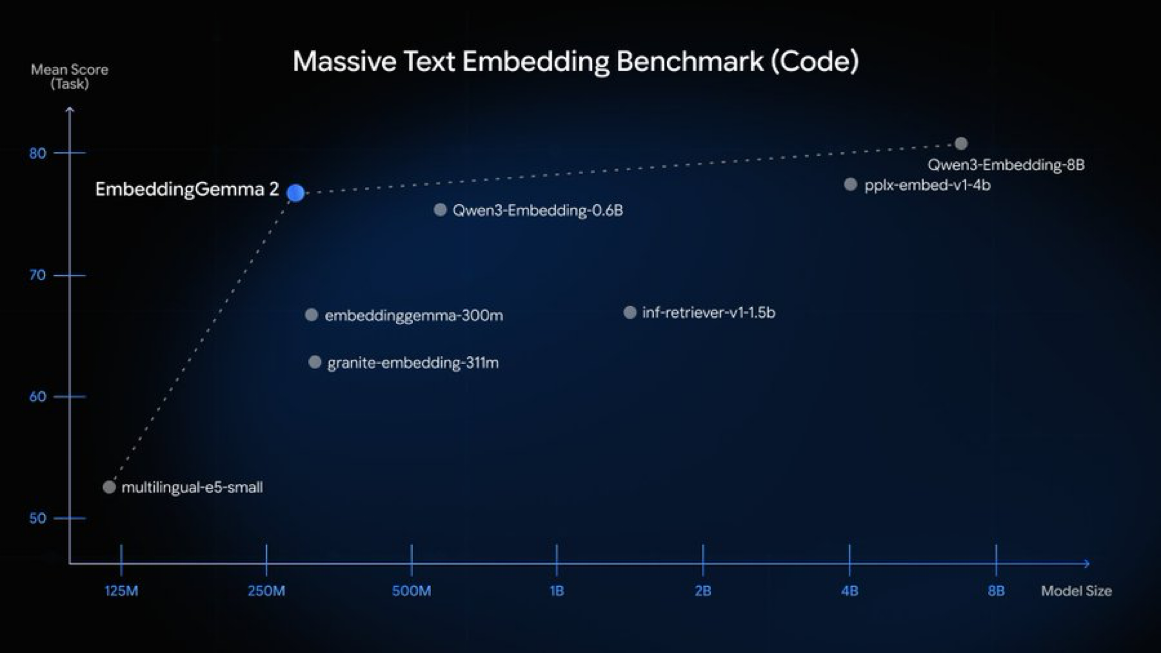 Recherche de code, d'après le fil de lancement de Google DeepMind et son article de blog.
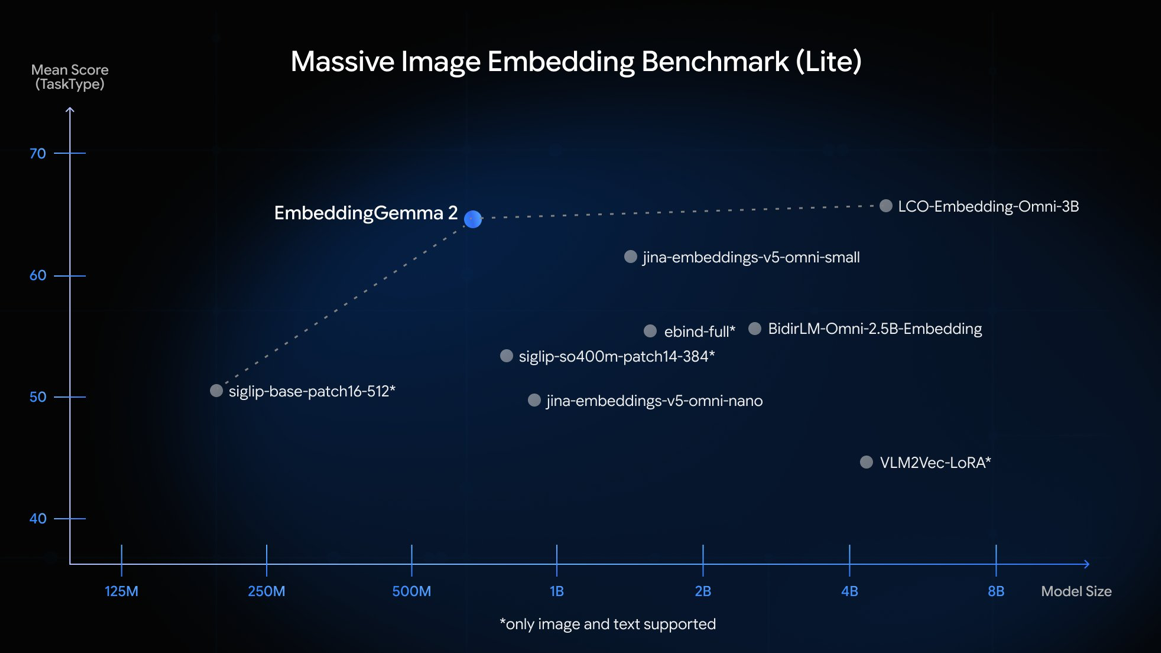 Recherche d'images, d'après le fil de lancement de Google DeepMind et son article de blog.
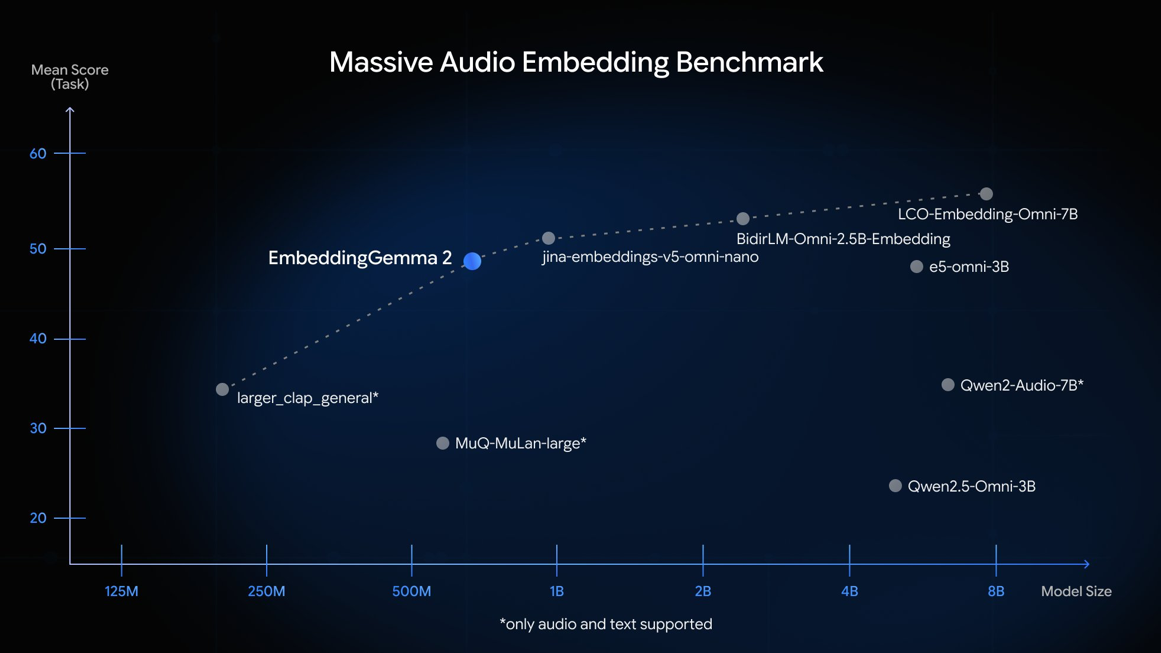 Embeddings audio, d'après le fil de lancement de Google DeepMind et son article de blog.
Valeurs lues sur les graphiques, approximativement :
- Code (MTEB Code) : EmbeddingGemma 2 obtient environ 77. C'est nettement au-dessus de son prédécesseur de 300 millions de paramètres, embeddinggemma-300m (environ 67), d'inf-retriever-v1-1.5b (environ 67) et de granite-embedding-311m (environ 63). Il est à peu près au niveau de Qwen3-Embedding-0.6B (environ 75,5) et de pplx-embed-v1-4b (environ 77,5), un modèle plus de cinq fois plus gros. Seul Qwen3-Embedding-8B, à environ 81, est nettement devant.
- Image (MIEB Lite) : environ 65, contre environ 66 pour LCO-Embedding-Omni-3B, environ 61,5 pour jina-embeddings-v5-omni-small et environ 53,5 pour SigLIP so400m, qui ne gère que l'image et le texte.
- Audio (MAEB) : environ 48,5, devant e5-omni-3B (environ 48) et Qwen2-Audio-7B (environ 35), mais derrière jina-embeddings-v5-omni-nano (environ 51), BidirLM-Omni-2.5B (environ 53) et LCO-Embedding-Omni-7B (environ 56).
Ce que les affirmations permettent de conclure
Google parle d'un modèle « compétitif sur l'ensemble des benchmarks », surpassant même certains modèles spécialisés plus de deux fois plus gros. Les graphiques le confirment : sur les trois, EmbeddingGemma 2 se situe sur la ligne de frontière, ou tout près, pour sa taille, un seul modèle de 740 millions de paramètres atteignant presque le niveau des modèles omni de 3 milliards sur les images et égalant un modèle de 4 milliards sur le code. Il n'est cependant premier nulle part. Le meilleur est Qwen3-Embedding-8B sur le code, LCO-Embedding-Omni-3B sur les images et LCO-Embedding-Omni-7B sur l'audio, et l'audio est le moins bon des trois résultats, avec quatre modèles mieux classés.
L'argument tient à l'étendue et à l'empreinte plutôt qu'à un record unique : un seul petit modèle Apache 2.0 couvrant cinq modalités.
Contexte
Apache 2.0 se situe près de l'extrémité permissive de l'échelle décrite dans Ouvert jusqu'où ? Petit guide des licences de modèles d'IA, et un modèle de 740 millions de paramètres est à l'opposé, côté taille, des modèles évoqués dans Ces poids ouverts que vous ne pouvez pas faire tourner. SigLIP, la référence image du graphique de Google, est expliqué dans SigLIP expliqué : pourquoi une perte plus simple a détrôné celle de CLIP. Pour d'autres petits modèles conçus pour tourner en local, voir les modèles embarqués de Desert Ant Labs.