
Liquid AI a publié Open d1 le 7 octobre 2026 : deux modèles à poids ouverts issus de sa famille de décision d1, dont les poids sont disponibles sur Hugging Face. d1-3B accepte le texte et la vision, et d1-omni-600M accepte du texte plus une image ou de l'audio. Les modèles de décision renvoient une réponse en une seule passe avant plutôt que de générer des jetons. Sur la partie publique de Decision Index v0.2.1, d1-3B obtient 48,57, devant tous les modèles de moins de 10B et au niveau de Decider 35B-A3B, un modèle de décision 12 fois plus gros. d1-omni-600M, expérimental, obtient 15,95. L'article de blog de Liquid destine le duo à tous les usages, des NVIDIA DGX en centre de données aux Jetson en périphérie.
Des modèles de décision, pas des générateurs
Contrairement aux LFM génératifs de Liquid, les modèles d1 produisent une décision : une réponse oui/non assortie d'une probabilité, un choix parmi plusieurs options avec une confiance et des probabilités par critère, ou un score avec une confiance. Dans les schémas, un état et un modèle d'instruction entrent, et une tête lit la décision sur la dernière couche.
d1-3B part de LFM2.5-VL-3B. Liquid a moyenné les poids de LFM2.5-2.6B avec ceux du socle textuel de ce modèle pour obtenir une base plus solide, a affiné des points de contrôle avec différentes graines et différents mélanges de données, puis les a fusionnés à nouveau. L'entraînement sur de longues entrées, le mélange aléatoire des options de réponse et la correction des raccourcis dans les données ont compté plus que des techniques plus avancées.
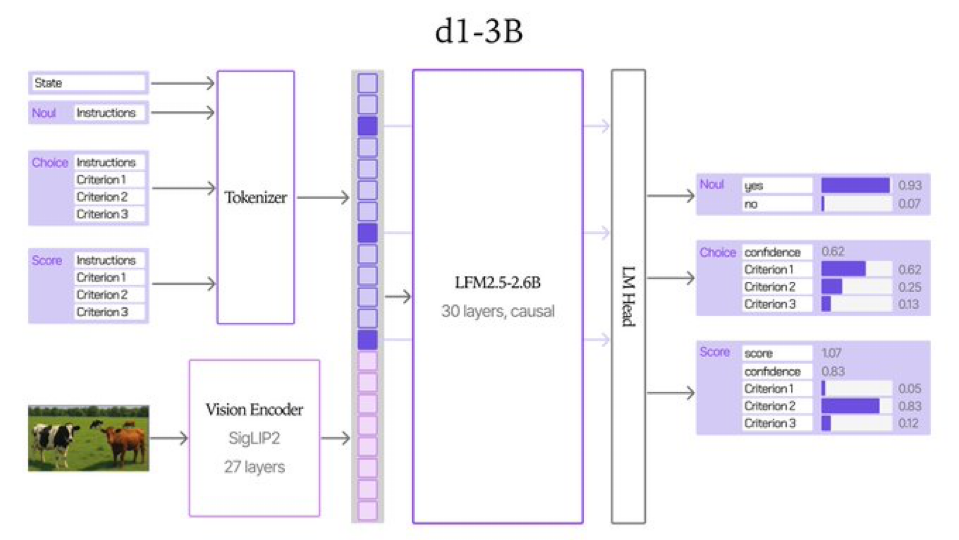 Tiré de l'article de blog de Liquid AI.
d1-omni-600M repose sur LFM2.5-Encoder-350M, un encodeur bidirectionnel, auquel sont rattachés un encodeur de vision SigLIP2 ou un encodeur audio FastConformer. Il a d'abord été affiné sur des tâches de décision, puis l'audio et la vision ont été ajoutés par étapes : l'encodeur audio a été ajusté face à un socle textuel figé, et l'encodeur de vision de LFM2.5-VL-450M a été ajouté avec un adaptateur et des mises à jour LoRA actives uniquement en présence d'images. Un affinage complet, une fusion LoRA et un moyennage des poids ont clos le processus.
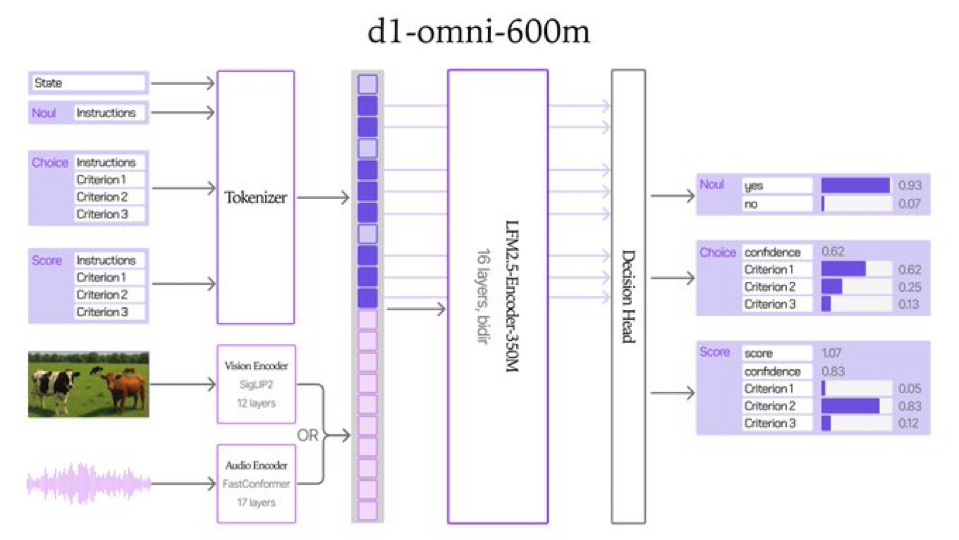 Tiré de l'article de blog de Liquid AI.
Benchmarks
Sur le graphique du Decision Index, d1-3B se situe à environ 48,5 pour 3B de paramètres, sur la frontière taille-score, et d1-omni-600M à environ 16 pour 0,6B. Les modèles affinés et les approches par techniques d'inférence, jusqu'à 32B, se placent entre environ 40 et 57, et deux API hébergées sont plus haut, d1 à environ 60 et Jev 1.13 à environ 57 à 58.
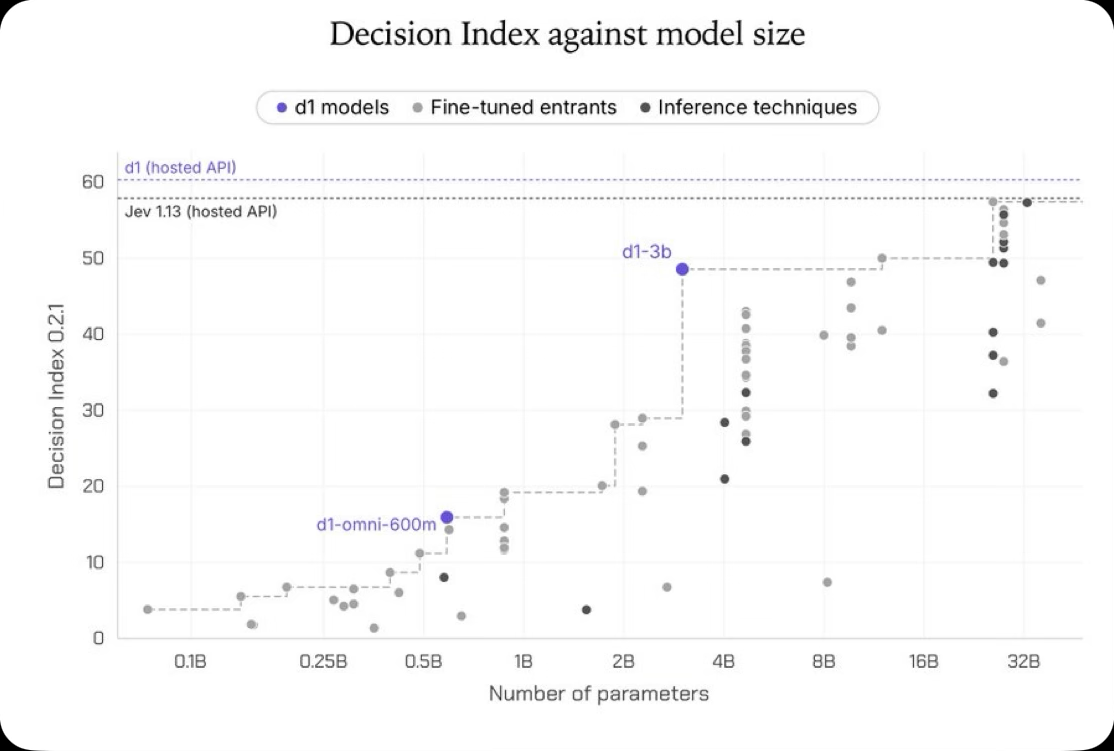 Tiré du fil de Liquid AI.
Sur sept benchmarks textuels publics, d1-3B a la meilleure moyenne, 82,9 contre 81,1 pour Decider 4B. Les 78,4 de d1-omni-600M devancent les 77,1 de Decider 2B avec 0,6B de paramètres, moins d'un tiers de sa taille.
| Benchmark | d1-omni-600M | d1-3B | Decider 2B | Decider 4B |
|---|---|---|---|---|
| SQuAD 2.0 | 74,0 | 85,3 | 67,7 | 76,0 |
| Civil Comments | 95,8 | 93,0 | 93,6 | 92,8 |
| MASSIVE intent | 86,1 | 87,3 | 81,1 | 88,3 |
| PubMedQA | 61,3 | 66,0 | 65,7 | 63,3 |
| BoolQ | 77,7 | 86,7 | 87,3 | 89,0 |
| XNLI | 74,7 | 85,0 | 85,0 | 88,6 |
| PAWS-X | 79,5 | 76,9 | 59,5 | 69,8 |
| Moyenne | 78,4 | 82,9 | 77,1 | 81,1 |
Les moyennes se recalculent exactement, mais la moyenne masque le détail ligne par ligne. d1-3B ne remporte que deux lignes, SQuAD 2.0 et PubMedQA ; Decider 4B gagne MASSIVE, BoolQ (89,0 contre 86,7) et XNLI (88,6 contre 85,0), et d1-3B ne fait qu'égaler Decider 2B sur XNLI à 85,0. Le petit modèle omni prend les deux autres, Civil Comments (toxicité) et PAWS-X (paraphrase).
Decision Index v0.3 comporte une partie vision privée qui n'est pas publiée ; Liquid a vérifié que d1-3B conserve les capacités de vision de LFM2.5-VL-3B sur les benchmarks standard et que d1-omni-600M gère les trois modalités dans ses démos du playground. Il n'existe pas encore de benchmarks de décision audio dédiés, et Liquid espère que la communauté les construira.
Rapide sur le matériel embarqué
Comme rien n'est généré, la latence se mesure de bout en bout. Les chiffres de Liquid pour d1-3B, une requête à la fois (appareils embarqués mesurés avec NVIDIA) :
| Appareil | 1 question | 3 questions | état de 3,4K jetons | image 384 px | 64 états groupés |
|---|---|---|---|---|---|
| RTX 4090 | 8 ms | 21 ms | 102 ms | 17 ms | 475/s |
| AMD MI325X | 9 ms | 14 ms | 44 ms | 18 ms | 1 106/s |
| Jetson AGX Thor | 16 ms | 20 ms | 220 ms | 35 ms | 262/s |
| Jetson AGX Orin 64GB | 26 ms | 35 ms | 560 ms | 83 ms | 110/s |
| Apple M5 Pro | 30 ms | 41 ms | 640 ms | 62 ms | 78/s |
| Jetson Orin Nano | 50 ms | 73 ms | 1 640 ms | 202 ms | 38/s |
Une seule question reste à 50 ms ou moins sur tous les appareils, et sous 10 ms sur les deux GPU. Trois questions coûtent environ 1,3 fois une seule question sur les appareils embarqués (Thor passe de 16 à 20 ms, soit un rapport de 1,25) ; la RTX 4090 paie environ 2,6 fois. La prise en charge de llama.cpp avec NVFP4 est disponible dès le premier jour sur Apple, AMD, Qualcomm et NVIDIA. Les chiffres ne concernent que d1-3B, d1-omni-600M étant une version de recherche préliminaire.
Ce que l'on peut construire
Liquid a publié dix démos dans un espace Hugging Face, sans installation, qui font tourner d1-3B en boucle sur un flux caméra en direct, une passe par image. Elles vont de jeux pilotés par gestes à la modération de contenu en direct. Avec NVIDIA, Liquid a aussi montré d1-3B naviguant dans un environnement dans Isaac Sim, servi depuis un Jetson dans une configuration de matériel en boucle.
Contexte
d1-3B s'appuie sur LFM2.5-VL-3B, le modèle vision-langage de Liquid, et sur les poids de LFM2.5-2.6B, le petit modèle que Liquid destinait aux agents locaux. Le petit travailleur spécialisé de NVIDIA est présenté dans Nemotron 3.5 Lightning, et EmbeddingGemma 2 est un autre modèle multimodal dimensionné pour l'embarqué.