
Microsoft a lancé Microsoft-Decision-1 le 9 octobre 2026, un modèle de prise de décision rapide disponible dans Microsoft Foundry et via OpenRouter. Il est post-entraîné à partir de Qwen3.5-9B et renvoie en une seule passe une probabilité calibrée pour chaque option de réponse, pour des questions oui/non, à choix multiples et de notation, ainsi que pour l'évaluation par grille des réponses d'IA et des actions d'agents. Microsoft le destine au routage, à la classification, à la priorisation, à la vérification et au contrôle de flux de travail, et revendique la meilleure précision dans sa comparaison de 36 benchmarks et 147 137 questions, avec la réponse mesurée la plus rapide : une médiane (p50) de 85 ms, soit environ 35 fois plus vite que GPT-6 Sol. Le fil d'annonce de Satya Nadella indique que Microsoft le teste déjà « de la réponse aux incidents et du contrôle qualité à la découverte scientifique ».
Ce que fait un modèle de décision
Là où un LLM génère du texte ou raisonne longuement, un modèle de décision produit une sortie structurée que le logiciel peut exploiter immédiatement, à très faible coût. Microsoft-Decision-1 prend un ensemble fixe d'options et note chacune d'elles par un simple appel d'API structuré. Il sera bientôt rebasé sur d'autres modèles, dont des modèles Microsoft AI (MAI) et OpenAI. Ce blog a couvert un lancement similaire avec les modèles d1 ouverts de Liquid AI deux jours plus tôt.
Microsoft articule la conception autour de cinq défis :
- Vitesse. Ajouter 100 ms à chacune de 20 décisions séquentielles ajoute deux secondes.
- Généralisation. L'évaluation couvre des benchmarks tenus à l'écart de l'entraînement : routage, classement, contexte long, multilingue, hors distribution, raisonnement et sécurité. Microsoft a aussi pris plusieurs des meilleurs modèles publics du classement JevBench et les a exécutés sur 36 benchmarks supplémentaires, publics et privés.
- Robustesse. Perturber de huit façons la même requête inverse la décision dans 1,3 % des perturbations en moyenne, et dans aucune lorsque les descriptions des options sont reformulées ou que les options sont inversées ou mélangées.
- Calibration. Les probabilités font partie de l'API : une prédiction à 90 % doit donc être juste environ 9 fois sur 10.
- Sécurité. Sur 5 250 requêtes réparties dans 11 benchmarks couvrant les contenus nuisibles, les jailbreaks et les injections de prompt, le modèle a refusé les comportements nuisibles tout en conservant une grande utilité.
Benchmarks
La précision moyenne sur les 36 benchmarks place Microsoft-Decision-1 en tête à 83,5. La calibration (100 signifie que la confiance correspond exactement à la fréquence de réussite du modèle) le place troisième à 92,2.
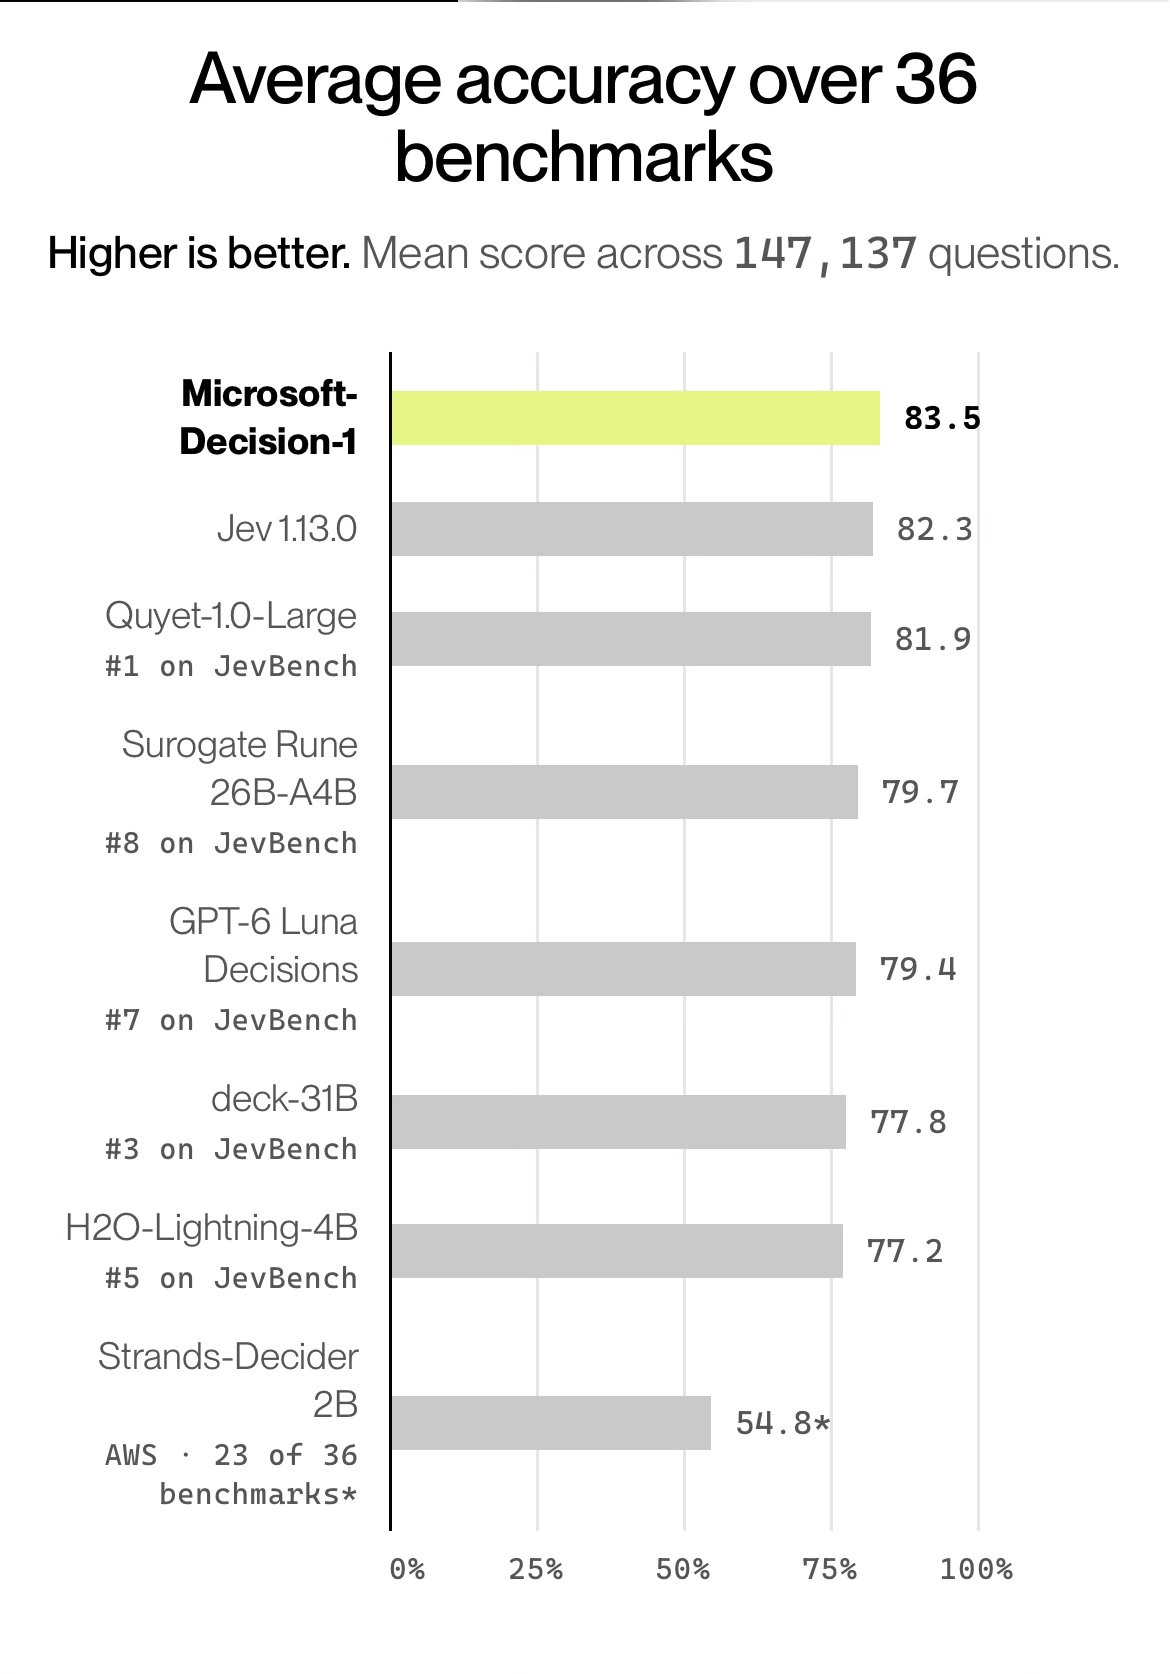 Tiré de l'article de lancement de Microsoft et du fil de Nadella.
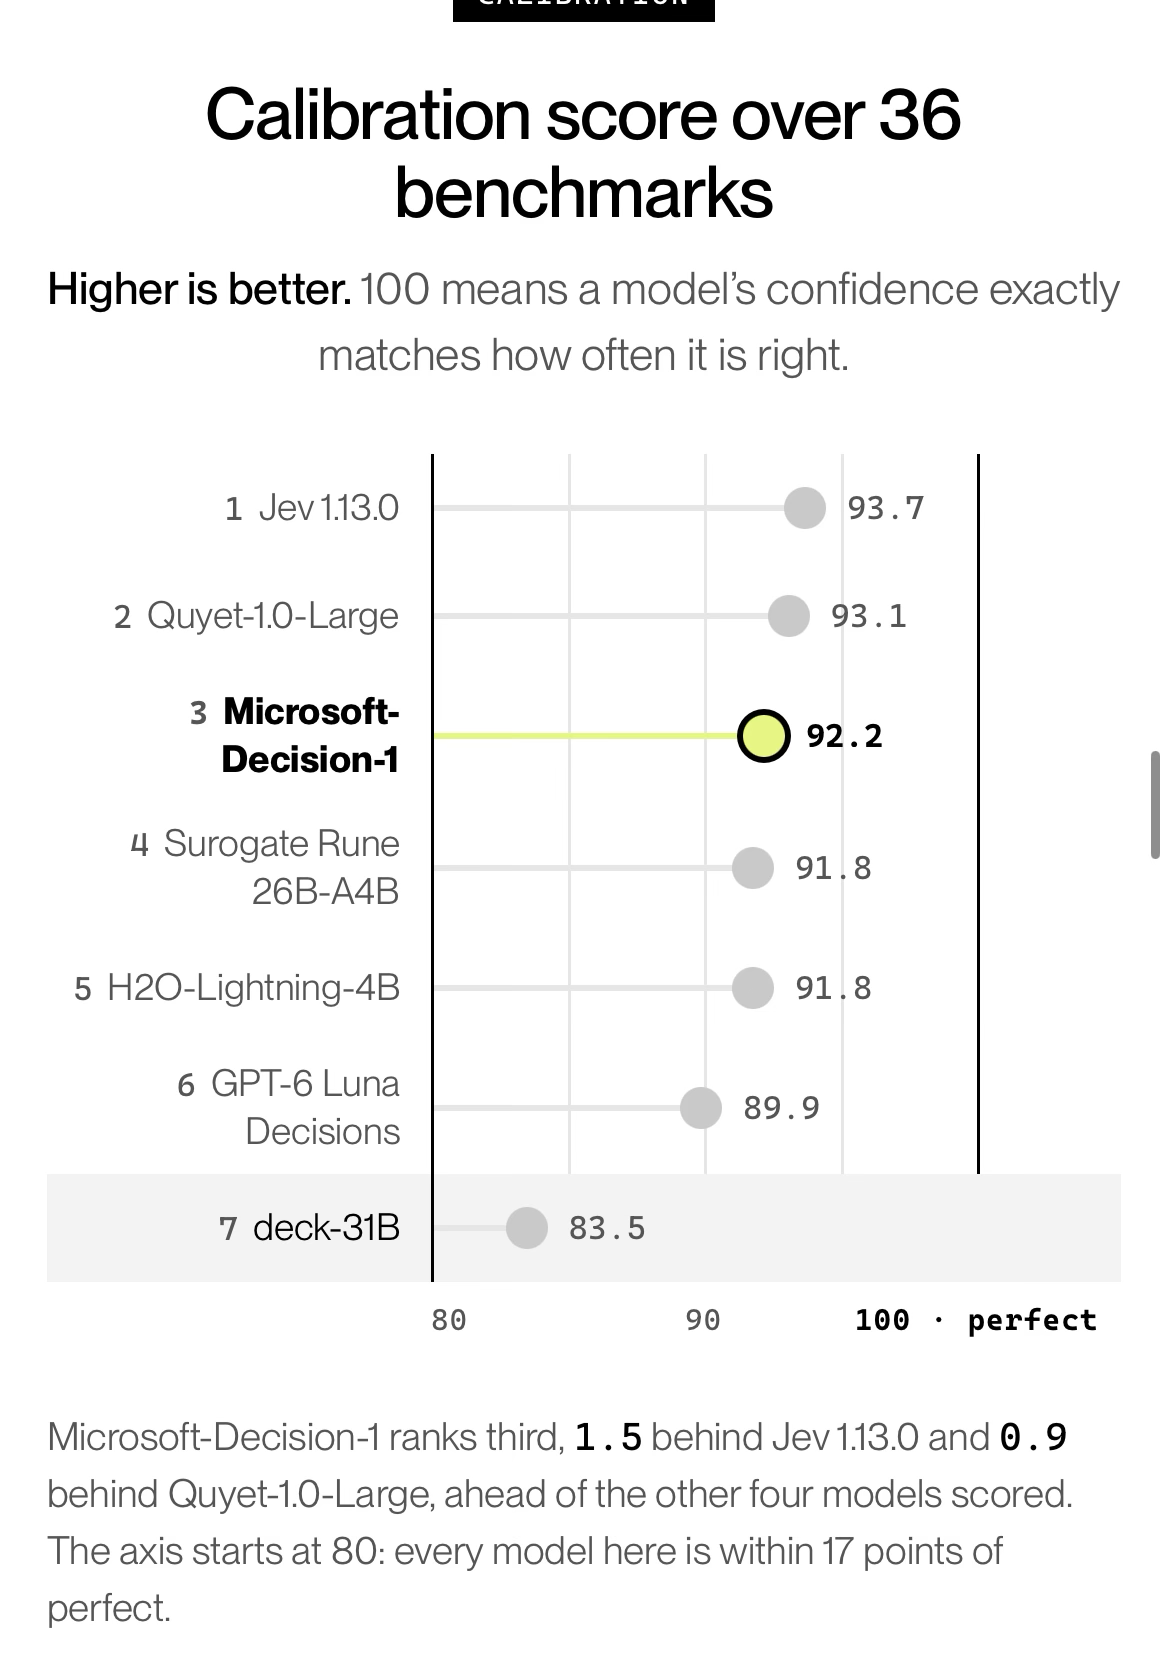 Tiré de l'article de lancement de Microsoft et du fil de Nadella.
| Modèle | Précision | Calibration | Latence médiane |
|---|---|---|---|
| Microsoft-Decision-1 | 83,5 | 92,2 | 85 ms |
| Jev 1.13.0 | 82,3 | 93,7 | 219 ms |
| Quyet-1.0-Large | 81,9 | 93,1 | 380 ms |
| Surogate Rune 26B-A4B | 79,7 | 91,8 | 380 ms |
| GPT-6 Luna Decisions | 79,4 | 89,9 | 299 ms |
| deck-31B | 77,8 | 83,5 | 394 ms |
| H2O-Lightning-4B (v1.1 pour la latence) | 77,2 | 91,8 | 201 ms |
| Strands-Decider 2B | 54,8* | n/d | n/d |
| GPT-6 Sol | n/d | n/d | 2,68 s |
Strands-Decider 2B (AWS) a été évalué sur 23 des 36 benchmarks, sa moyenne ne porte donc que sur ceux-ci. Les latences sont des médianes ajustées de JevBench, Microsoft-Decision-1 étant mesuré via Foundry dans la même région ; son p95 est de 125 ms.
L'avance en précision est modeste : 1,2 point sur Jev 1.13.0 et 1,6 sur Quyet-1.0-Large, qui occupe la première place de JevBench. Sur la calibration, le modèle est derrière Jev de 1,5 point et derrière Quyet-1.0-Large de 0,9, tout en devançant les quatre autres modèles notés ; chaque modèle présenté se situe à moins de 17 points de la perfection.
La vitesse est l'écart le plus large. Face à Quyet-1.0-Large, le modèle est 4,5 fois plus rapide (380 / 85), et face à H2O-Lightning-4B v1.1, le plus rapide des autres modèles de décision, 2,4 fois (201 / 85). Face à GPT-6 Sol, 2,68 s contre 85 ms font environ 31 fois avec les chiffres arrondis du tableau ; Microsoft avance environ 35 fois.
Chez Microsoft
Les équipes de Microsoft ont elles-mêmes testé le modèle :
- XBOX Research a classé plus de 10 000 retours ouverts issus d'enquêtes, de Steam et de Twitter/X dans des thèmes fixes. La qualité était comparable à celle de GPT-6 Sol, à plus de 14 fois la vitesse et à un coût 200 fois inférieur.
- L'équipe Copilot, qui note la qualité des réponses de chat et d'agents, l'a trouvé comparable à GPT-5.6 Luna et 100 fois plus rapide.
- Réponse aux incidents : pour les ingénieurs d'astreinte, il a récupéré les connaissances mieux et plus vite qu'un LLM.
- Microsoft Discovery : les scores étaient 46 fois plus cohérents qu'un score basé sur un LLM, à trois fois la vitesse, et la replanification adaptative s'exécutait près de quatre fois plus vite.
Deux démos illustrent le même point : une classification exécutée face à GPT-6 Sol, et un agent d'utilisation d'ordinateur qui achète un sac à dos plus vite qu'un agent piloté par GPT-6 Sol.
Où l'utiliser
La liste de cas d'usage de Microsoft comprend :
- les contrôles d'agents (continuer, arrêter, réessayer, passer la main)
- le routage de modèles
- le jugement par IA et l'étiquetage de données
- le routage de la réponse aux incidents
- le filtrage de sûreté et de sécurité
- l'utilisation d'ordinateur et d'interfaces
- la robotique
- la découverte scientifique
Contexte
GPT-6 Sol, la référence de latence ci-dessus, a été lancé le 22 septembre en même temps que Luna ; voir GPT-6 Sol et Luna. Le rebasage prévu sur les modèles MAI fait suite à l'annonce d'intelligence hybride de Windows par Microsoft, qui a amené le modèle de code MAI-Code-1.1 Flash sur le PC.