
Richard Socher a annoncé Flint, le premier modèle de Recursive : un modèle de code local et rapide, construit avec le système de recherche automatisé de l'entreprise, la Eureka Machine. Les poids ouverts sont disponibles sur Hugging Face, et le modèle peut être exécuté en local ou essayé gratuitement sur opencode et Pi. L'argument de Socher : « une intelligence privée et sans limite de consommation sur votre propre machine », conçue de zéro en moins de quatre mois. Selon la presse, le modèle est publié sous licence Apache 2.0 et prend en charge Ollama, LM Studio et llama.cpp.
Ce qu'est Flint
Flint compte 40B paramètres au total, dont environ 2B actifs par token. Recursive affirme que sa Eureka Machine a contribué à la recette d'entraînement, à l'architecture et aux logiciels spécifiques aux puces, les chercheurs se contentant pour l'essentiel d'observer et de retenir les meilleures variantes. Recursive le compare à des modèles mixture-of-experts parcimonieux de 33 à 35B au total et 3B actifs (Qwen 3.5, Qwen 3.6, Laguna XS 2.1), ainsi qu'à des modèles denses de 27 à 31B (Qwen 3.8, Muse Glimmer, Gemma 4), tous capables de tourner sur un matériel similaire.
Vitesse
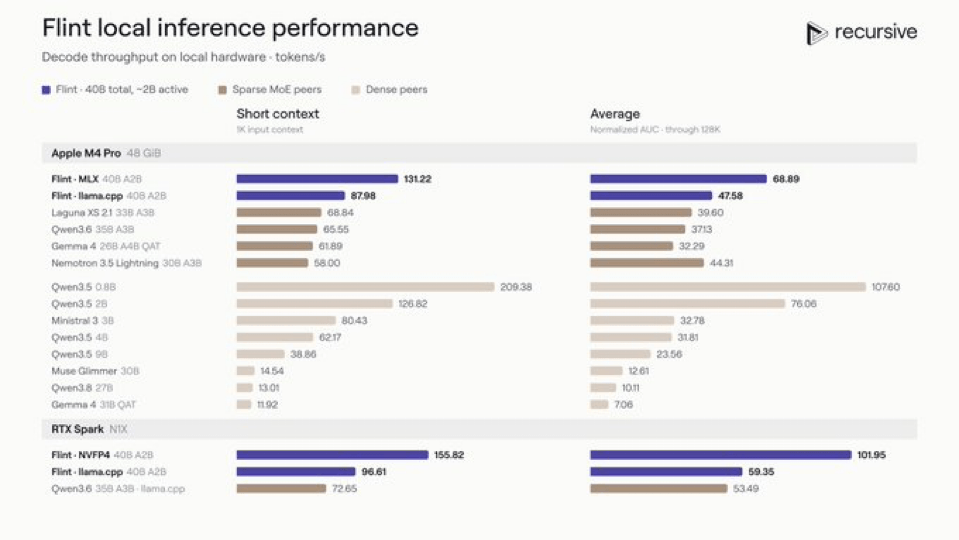 Débit de décodage local en tokens/s, d'après l'annonce de Recursive.
Sur un Apple M4 Pro de 48 GiB, Flint tourne à 131 tokens/s sous MLX et 88 sous llama.cpp en contexte court, contre 65,6 pour Qwen 3.6 35B A3B, 68,8 pour Laguna XS 2.1 et 61,9 pour Gemma 4 26B QAT. En moyenne sur une session de 128K, il tient 68,9 (MLX) et 47,6 (llama.cpp), contre 37,1 pour Qwen 3.6 et 44,3 pour Nemotron 3.5 Lightning. Sur le matériel RTX Spark, il atteint 156 tokens/s avec NVFP4 et 96,6 avec llama.cpp, contre 72,7 pour Qwen 3.6.
L'affirmation « jusqu'à 2x plus rapide » se vérifie avec la meilleure version de Flint : 131,2 contre 65,6 donne 2,0x, et la moyenne sur 128K donne 1,86x. Face à Qwen 3.6 sur le même framework llama.cpp avec RTX Spark, l'avance est de 1,33x en contexte court et de 1,11x sur la moyenne en contexte long. Les modèles denses sont nettement plus lents (Qwen 3.8 27B à 13 tokens/s, Muse Glimmer 30B à 14,5).
Qualité
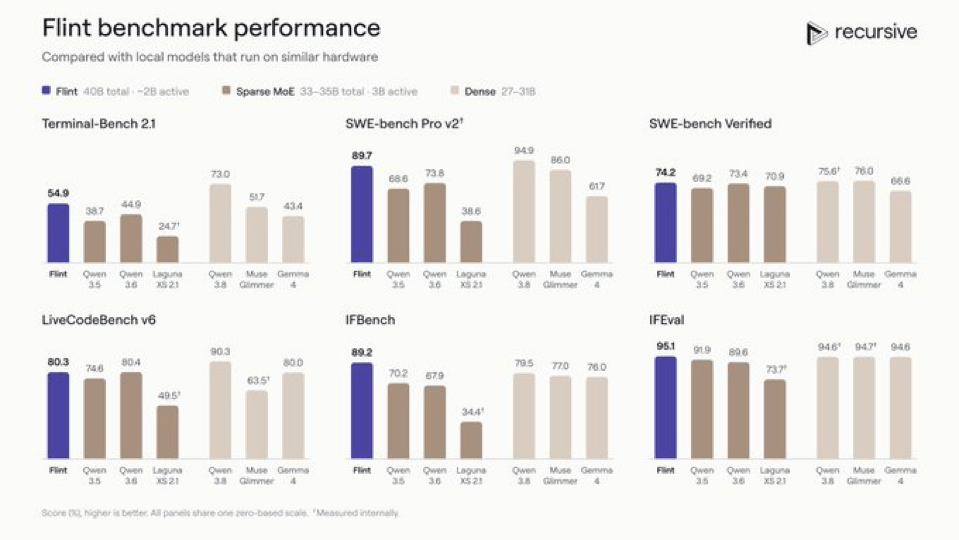 Scores de benchmarks (%), d'après l'annonce de Recursive. Les croix (†) signalent les scores mesurés en interne.
| Benchmark | Flint | Qwen 3.6 | Muse Glimmer | Qwen 3.8 | Gemma 4 |
|---|---|---|---|---|---|
| Terminal-Bench 2.1 | 54.9 | 44.9 | 51.7 | 73.0 | 43.4 |
| SWE-bench Pro v2 | 89.7 | 73.8 | 86.0 | 94.9 | 61.7 |
| SWE-bench Verified | 74.2 | 73.4 | 76.0 | 75.6 | 66.6 |
| LiveCodeBench v6 | 80.3 | 80.4 | 63.5 | 90.3 | 80.0 |
| IFBench | 89.2 | 67.9 | 77.0 | 79.5 | 76.0 |
| IFEval | 95.1 | 89.6 | 94.7 | 94.6 | 94.6 |
La moyenne des six lignes donne environ 80,6 pour Flint, contre 71,7 pour Qwen 3.6, 74,8 pour Muse Glimmer et 84,7 pour le Qwen 3.8 27B dense. Flint devance tous les modèles parcimonieux sur les six benchmarks, sauf LiveCodeBench (80,3 contre 80,4 pour Qwen 3.6), et bat Muse Glimmer sur cinq des six. Qwen 3.8 est en tête sur quatre, mais tourne ici à environ 10 tokens/s en moyenne, contre 48 à 69 pour Flint. La comparaison porte sur SWE-bench Pro v2, une version différente des scores SWE-Bench Pro cités dans l'article consacré à Glimmer.
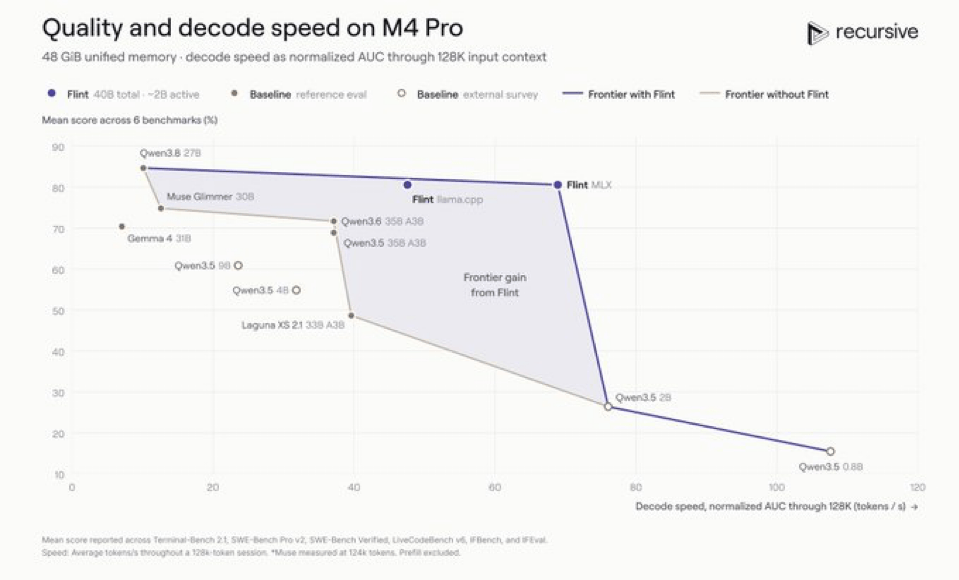 Score moyen en fonction de la vitesse de décodage sur un M4 Pro, d'après l'annonce de Recursive.
Le graphique de Recursive grise un « gain de frontière dû à Flint » entre le Qwen 3.8 27B dense, de meilleure qualité mais lent, et les petits Qwen 3.5 2B et 0.8B, rapides mais peu performants. Les scores et les vitesses sont ceux de Recursive, mesurés sur son propre matériel.