
Reflection AI a publié Beam, son premier modèle à poids ouverts, avec des poids disponibles sur Hugging Face sous licence Apache 2.0. Beam est un Mixture-of-Experts parcimonieux de 501 milliards de paramètres au total, dont 23 milliards actifs par token, soit environ 4,6 % du total, conçu pour le codage avancé, le raisonnement et le travail agentique de longue haleine, avec ce que Reflection appelle une efficacité de raisonnement de pointe. Il est lancé avec plus de 40 partenaires et le harnais open source sur lequel il a été entraîné, Mirror CLI, que Reflection décrit comme « un système d'exploitation ouvert pour les agents » : « Le modèle est le noyau, et tout ce qui se trouve au-dessus de la couche d'infrastructure est ouvert. »
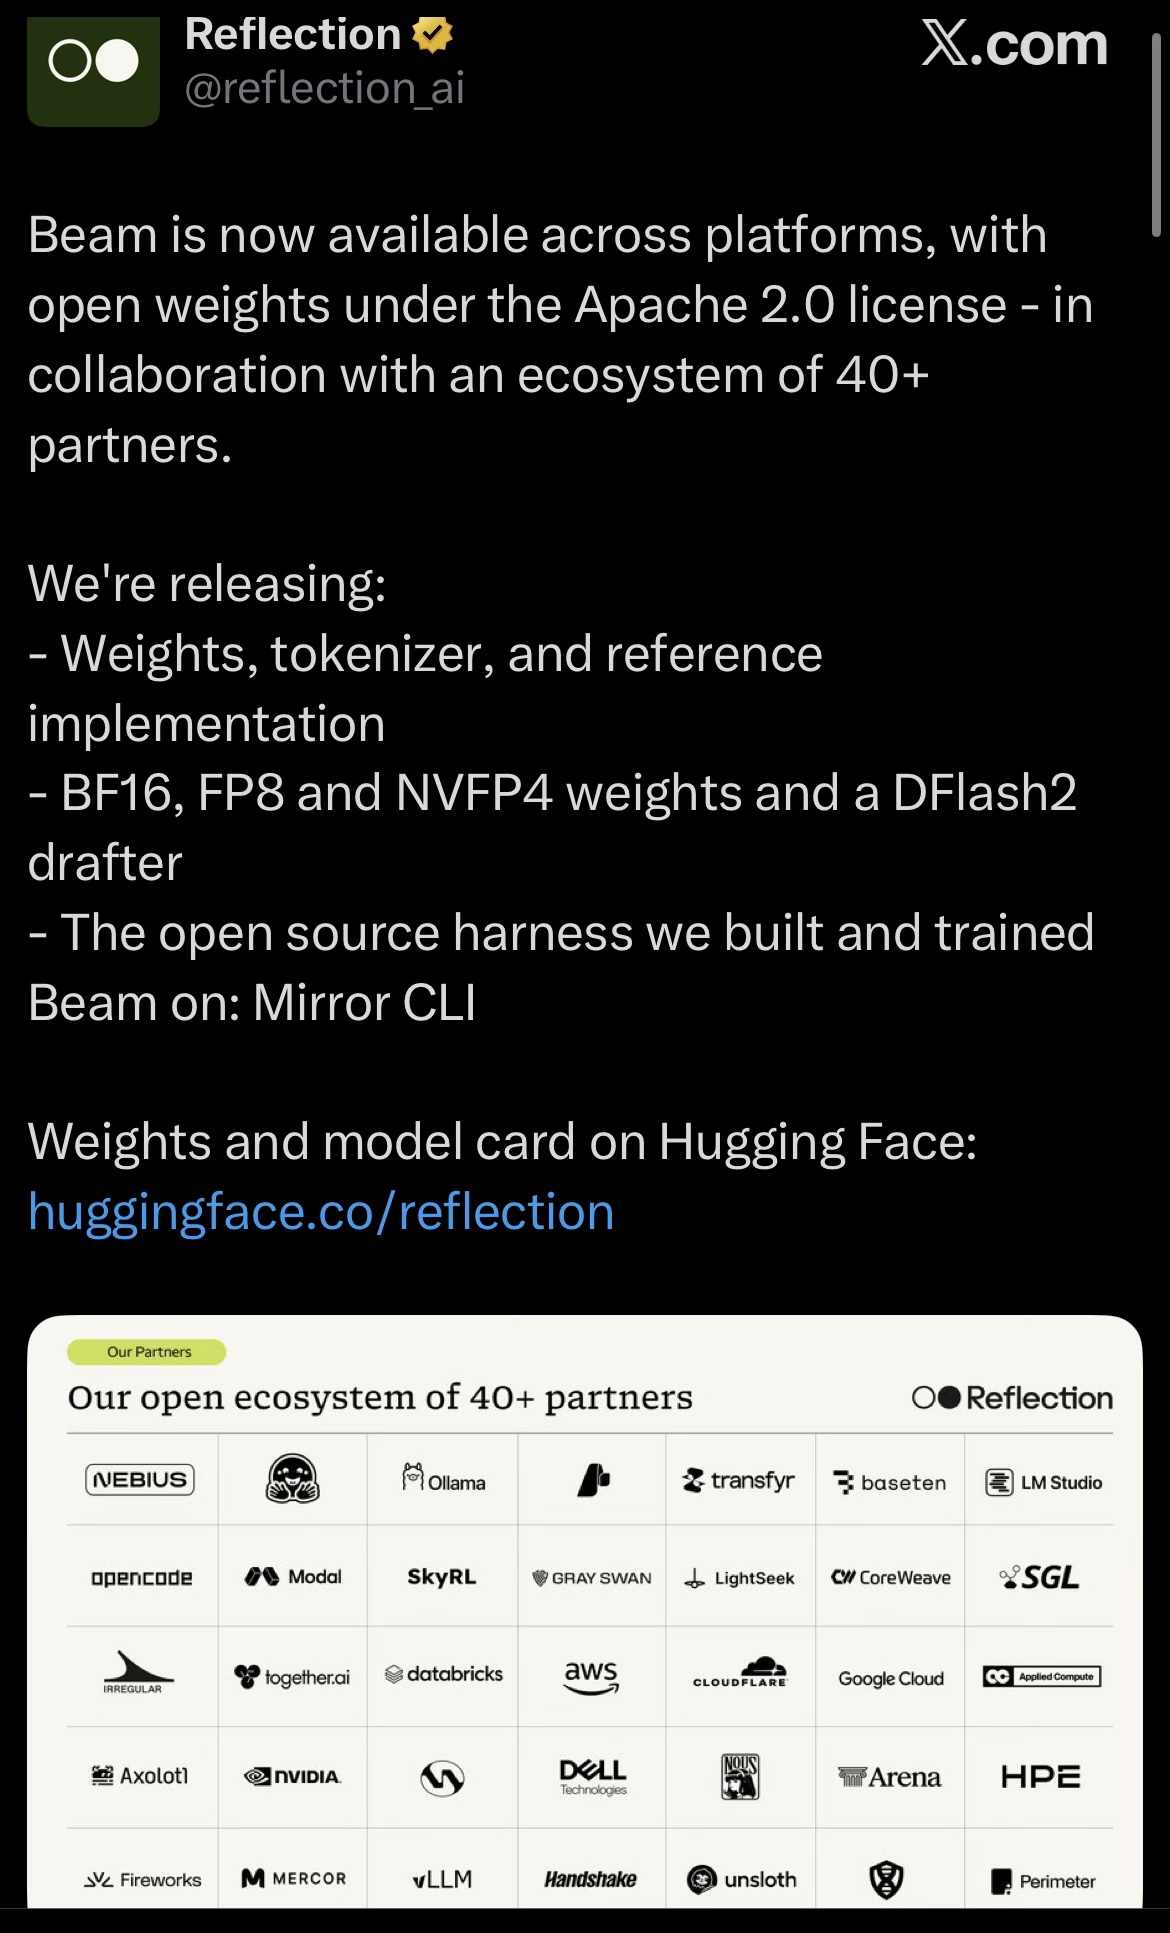 Extrait de l'annonce de Reflection.
Ce qui est publié
Reflection publie les poids, le tokenizer et une implémentation de référence. Les poids sont proposés en BF16, FP8 et NVFP4, accompagnés d'un drafter de décodage spéculatif (DFlash2). Les partenaires ont ajusté des configurations de serving et des kernels fusionnés pour ces formats.
La fiche du modèle sur Hugging Face présente les benchmarks définitifs, et un rapport technique distinct, le Beam Safety Technical Report, décrit la méthodologie de sécurité et les évaluations. Le support dès le premier jour couvre Transformers (Hugging Face), vLLM (Inferact), SGLang (RadixArk), Unsloth, Axolotl, TokenSpeed (LightSeek Foundation) et Dynamo (NVIDIA). Tout ce qui se trouve au-dessus de la couche d'infrastructure est ouvert, affirme Reflection : intégrations agentiques de référence, conteneurs de déploiement, intégrations d'inférence et pipelines de personnalisation.
Mirror CLI
Beam a été entraîné conjointement avec Mirror CLI pour des performances optimales, et il est également intégré à d'autres harnais ouverts : Reflection l'a testé avec Pi (Earendil), OpenCode (Anomaly) et Hermes (Nous Research) sur des tâches de codage et de travail de connaissance telles que lire des dépôts, modifier des fichiers et exécuter des commandes.
Mirror fait tourner Beam depuis un terminal, sur n'importe quel checkpoint ou endpoint. Les utilisateurs peuvent inspecter l'activité, approuver les appels d'outils, orienter l'agent, reprendre des conversations et lancer des agents en parallèle dans des worktrees séparés. Il prend en charge les instructions de projet, les skills, MCP et les extensions Python. L'architecture associe un frontend Python pour les prompts, les skills et les outils de développement à un cœur d'agent Rust minimal qui pilote le modèle via une connexion locale, ce qui en fait aussi une surface d'évaluation propre.
Reflection a d'abord construit Mirror pour un usage interne, avec des espaces de travail isolés, des sessions en arrière-plan et des intégrations Slack, Linear et GitHub ; les agents continuaient à travailler après la fermeture des ordinateurs portables, avec les plus grands gains sur la revue de code. Ces enseignements ont aidé à entraîner Beam à fonctionner avec différents harnais avant l'ouverture du code de Mirror. Le choix du harnais compte : l'étude DeepSWE de 8090 Labs, qui incluait Pi et OpenCode, a trouvé un même modèle obtenant 24 % ou 59 % selon le harnais.
Entraînement et personnalisation
Sur l'ensemble de l'entraînement, de l'évaluation et des ablations, les plus grands runs de RL de Reflection ont mobilisé environ 1,3 milliard de sandboxes. À l'heure de pointe du run de RL final, la flotte a atteint 883 006 vCPU répartis sur 23 clusters sur GCP et AWS, soit 83 % de la capacité allouable (ce qui implique environ 1,06 million de vCPU allouables). Les enseignements ont été remontés en amont, notamment OpenEnv, un standard ouvert d'environnements que Reflection adoptera pour ses prochains runs.
Pour le post-entraînement, Reflection s'est associé à NVIDIA (NeMo RL, AutoModel, Megatron), RadixArk (Miles), Hugging Face (TRL), Anyscale (SkyRL) et Axolotl. Il décrit aussi une boucle d'auto-distillation de Beam : générer des traces sur vos propres tâches, entraîner un adaptateur LoRA sur les traces vérifiées, et recommencer. Des recettes sont promises dans les prochains jours.
Premiers cas d'usage
Trois premiers créateurs ont construit des projets avec Beam :
- Lorenzo Balderrama Porras (CoreWeave) a réalisé un escape game dans lequel Beam répare une machine planétaire, fait passer la lumière par des miroirs et planifie l'évasion d'un robot. Beam reçoit les règles et l'état via des outils et exécute du Python dans CoreWeave Sandbox.
- Wesche (@WescheNex1q), avec Hermes via le Nous Portal, a donné la même tâche à quatre modèles : un jardin de pagodes en voxels sur une seule page HTML. Beam, sous le nom de code MissingNo, a produit la pagode, les cerisiers et le pin en 117 secondes avec 12,6 K tokens et une correction d'une ligne.
- Adam Roman (@adamisnotroman), avec OpenCode, a demandé à Beam (nom de code Catjam) et à Big Pickle de construire un jeu Snake pour navigateur mobile à partir du même prompt. Les temps de construction rapportés sont de 2:19,7 pour Beam et de 4:56,4 pour Big Pickle, soit 139,7 secondes contre 296,4 : Beam a donc terminé environ 2,1 fois plus vite.
Où le trouver
Au lancement, Beam est disponible sur Amazon Web Services, Microsoft Azure, Google Cloud, Oracle, Nebius, CoreWeave, Databricks, Cloudflare, Vercel, Modal, Baseten, Fireworks AI, Together AI, OpenRouter, NVIDIA NIMs, Ollama, LM Studio, OpenCode et Hermes, entre autres. Pour les déploiements sur site, souverains et en environnement isolé (air-gapped), Dell et HPE livrent Beam derrière le pare-feu.
L'API propriétaire de Reflection est en bêta publique gratuite sur platform.reflection.ai, avec la documentation sur developers.reflection.ai. Les testeurs de sécurité et d'évaluation remerciés par Reflection comprennent Andon Labs, Artificial Analysis, Arena, Gray Swan, Irregular, SecureBio et Snorkel AI.
Contexte
Beam arrive au milieu d'une série de grandes sorties à poids ouverts. NVIDIA a publié la veille Nemotron 3.5 Super VL, un modèle de 120 milliards de paramètres dont 12 milliards actifs, et le Kimi K3 de Moonshot, avec ses 2,8 billions de paramètres, a établi le record de taille en juillet, dans le cadre du basculement vers les poids lourds. Reflection AI figurait également parmi les laboratoires cités comme partenaires inauguraux de l'Open Secure AI Alliance de NVIDIA.