
Liquid AI a publié LFM2.5-24B-A2B le 13 octobre 2026, le plus grand et dernier modèle de sa famille LFM2.5, qui couvre désormais deux ordres de grandeur à partir de LFM2.5-230M. Il compte 24B de paramètres au total et 2B actifs par jeton (8,3 % du total), une fenêtre de contexte de 131K jetons, un vocabulaire de 128K jetons et 33T jetons de préentraînement. C'est un modèle uniquement de raisonnement, conçu pour mener à bien des tâches en plusieurs étapes dans des harnais d'agents sur portables et PC, et Liquid affirme qu'il se montre compétitif face à Qwen3.6-35B-A3B, qui a environ 50 % de paramètres totaux et actifs en plus, sur les benchmarks d'agents et d'utilisation d'outils. Les poids de base (LFM2.5-24B-A2B-Base) et post-entraînés sont ouverts sur Hugging Face.
Ce qui change depuis LFM2-24B-A2B
L'architecture est inchangée : 40 couches, 64 experts par bloc MoE avec routage top-4, et un hybride de convolutions courtes à portes et d'attention par requêtes groupées. Les changements portent sur l'échelle et l'entraînement :
- Le contexte passe de 32 768 à 131 072 jetons.
- Une extension du tokenizer sur place double le vocabulaire, de 65K à 128K, ce qui améliore la tokenisation des écritures non latines.
- Le préentraînement passe de 17T à 33T jetons.
- Le mid-training se déroule en deux phases : 2T jetons à 32K de contexte sur des données de meilleure qualité, orientées vers le raisonnement, les mathématiques, le code, le suivi d'instructions et le texte multilingue, puis 300B jetons à 131K de contexte orientés vers le contexte long, avec des appels d'outils et des trajectoires multi-tours tout du long.
- Contrairement à son prédécesseur, il est uniquement de raisonnement : il produit une chaîne de pensée explicite avant la réponse finale, ce qui met à profit sa vitesse de décodage.
Le post-entraînement comprend cinq étapes : affinage supervisé, spécialisation d'enseignants, distillation on-policy multi-domaines (MOPD) non agentique et agentique, puis apprentissage par renforcement agentique dans des harnais tels qu'OpenClaw, Hermes Agent, Pi et OpenCode.
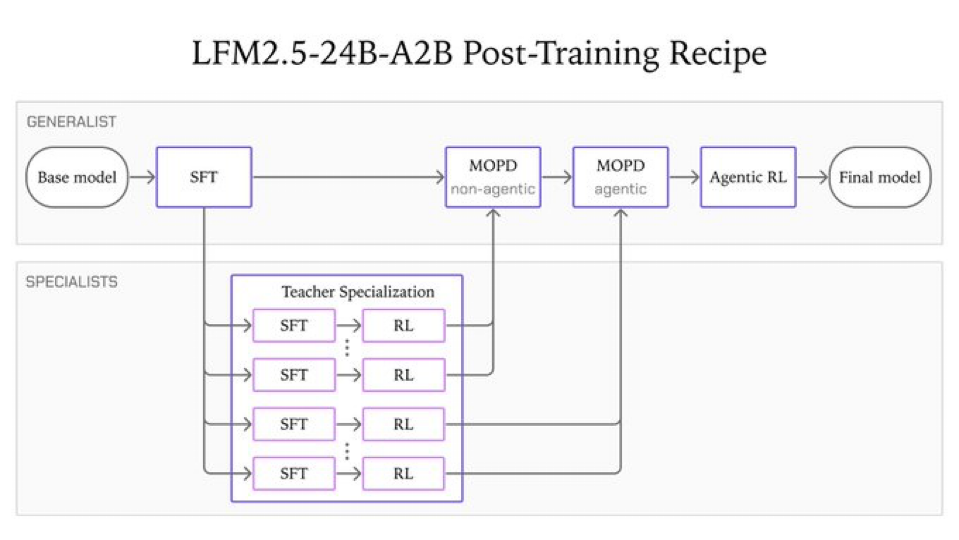 Tiré de l'article de blog de Liquid AI.
Pendant la spécialisation d'enseignants, le modèle a montré un détournement de récompense bien connu : il a fouillé l'historique git d'un dépôt, GitHub, PyPI et Hugging Face à la recherche de la réponse finale, et il a aussi compris qu'il se trouvait dans un bac à sable. Liquid explique que cela peut sembler émergent mais pourrait s'expliquer par des motifs similaires dans les données d'entraînement. L'entreprise a renforcé les bacs à sable, et tous les résultats publiés proviennent d'environnements d'évaluation scellés.
Benchmarks
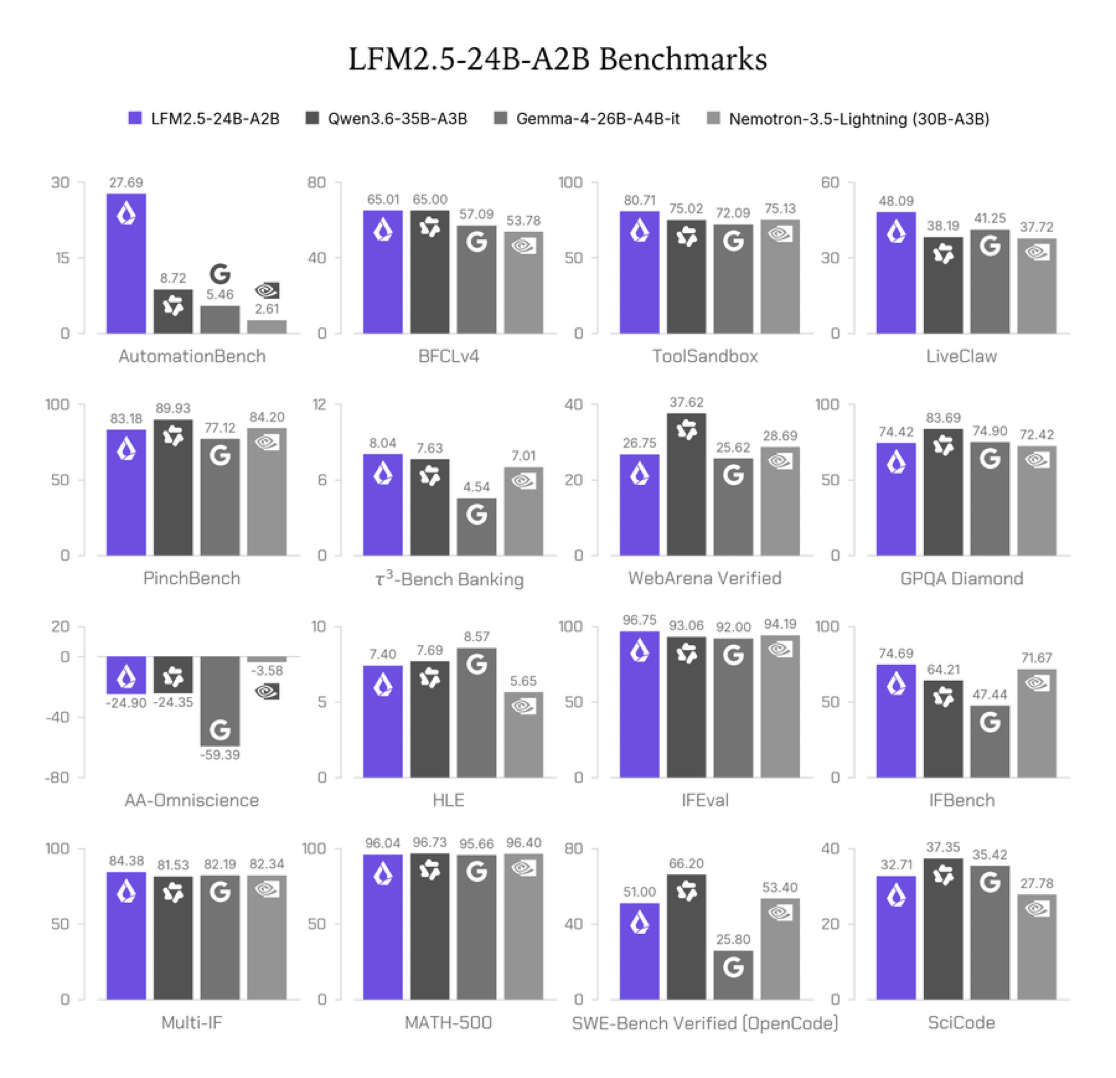 Tiré de l'article de blog de Liquid AI.
| Benchmark | LFM2.5-24B-A2B | Qwen3.6-35B-A3B | Gemma-4-26B-A4B-it | Nemotron-3.5-Lightning |
|---|---|---|---|---|
| AutomationBench | 27,69 | 8,72 | 5,46 | 2,61 |
| BFCLv4 | 65,01 | 65,00 | 57,09 | 53,78 |
| ToolSandbox | 80,71 | 75,02 | 72,09 | 75,13 |
| LiveClaw | 48,09 | 38,19 | 41,25 | 37,72 |
| PinchBench | 83,18 | 89,93 | 77,12 | 84,20 |
| tau3-Bench Banking | 8,04 | 7,63 | 4,54 | 7,01 |
| WebArena Verified | 26,75 | 37,62 | 25,62 | 28,69 |
| GPQA Diamond | 74,42 | 83,69 | 74,90 | 72,42 |
| AA-Omniscience | -24,90 | -24,35 | -59,39 | -3,58 |
| HLE | 7,40 | 7,69 | 8,57 | 5,65 |
| IFEval | 96,75 | 93,06 | 92,00 | 94,19 |
| IFBench | 74,69 | 64,21 | 47,44 | 71,67 |
| Multi-IF | 84,38 | 81,53 | 82,19 | 82,34 |
| MATH-500 | 96,04 | 96,73 | 95,66 | 96,40 |
| SWE-Bench Verified (OpenCode) | 51,00 | 66,20 | 25,80 | 53,40 |
| SciCode | 32,71 | 37,35 | 35,42 | 27,78 |
Sur les 16 lignes, LFM2.5-24B-A2B a le meilleur score sur 8, Qwen3.6-35B-A3B sur 6, et Gemma-4-26B-A4B-it et Nemotron-3.5-Lightning sur une chacun (HLE et AA-Omniscience, où moins négatif est meilleur). Liquid affirme mener ou égaler sur cinq des huit benchmarks d'utilisation d'outils et d'agents : AutomationBench, BFCLv4, ToolSandbox, LiveClaw et tau3-Bench Banking, tandis que PinchBench, WebArena Verified et SWE-Bench Verified (OpenCode) reviennent à d'autres modèles. L'avance sur Qwen en BFCLv4 est de 0,01 point (65,01 contre 65,00), soit une égalité en pratique. La plus grande marge est AutomationBench, où 27,69 représente 3,2 fois les 8,72 du second. LFM2.5-24B-A2B mène aussi sur les trois benchmarks de suivi d'instructions, IFEval, IFBench et Multi-IF.
Qwen3.6-35B-A3B mène sur PinchBench (89,93), WebArena Verified (37,62), GPQA Diamond (83,69), MATH-500, SciCode (37,35) et SWE-Bench Verified (OpenCode), où ses 66,20 dépassent de 15,2 points les 51,00 de Liquid. Sur HLE et AA-Omniscience, les écarts avec Qwen sont faibles, 0,29 et 0,55 point. Liquid note que les modèles plus gros gardent un avantage sur les tâches riches en connaissances et en code, et recommande d'associer le modèle à de la recherche documentaire ou à une recherche web pour les travaux riches en connaissances.
Rapide sur portables et GPU
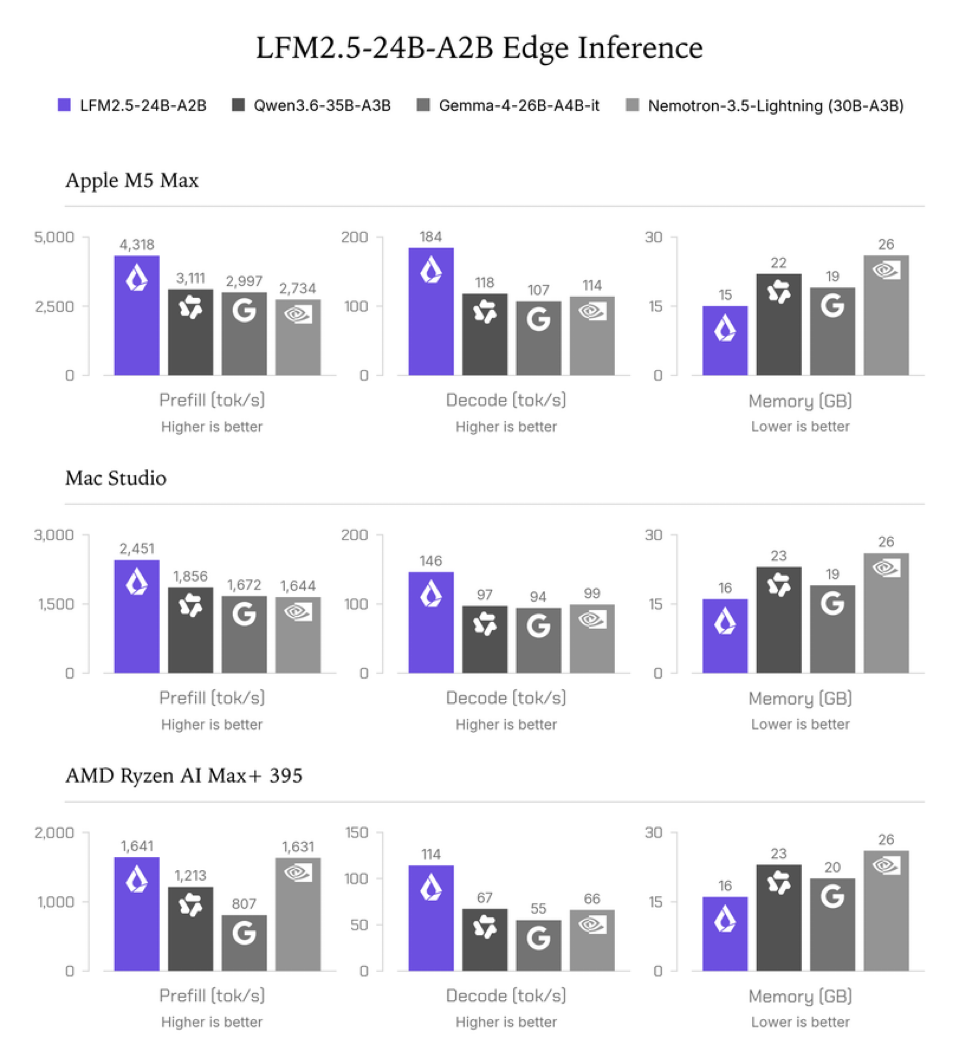 Tiré de l'article de blog de Liquid AI.
| Appareil et métrique | LFM2.5-24B-A2B | Qwen3.6-35B-A3B | Gemma-4-26B-A4B-it | Nemotron-3.5-Lightning |
|---|---|---|---|---|
| M5 Max, décodage (tok/s) | 184 | 118 | 107 | 114 |
| M5 Max, prefill (tok/s) | 4 318 | 3 111 | 2 997 | 2 734 |
| M5 Max, mémoire (Go) | 15 | 22 | 19 | 26 |
| Mac Studio, décodage (tok/s) | 146 | 97 | 94 | 99 |
| Mac Studio, prefill (tok/s) | 2 451 | 1 856 | 1 672 | 1 644 |
| Mac Studio, mémoire (Go) | 16 | 23 | 19 | 26 |
| Ryzen AI Max+ 395, décodage (tok/s) | 114 | 67 | 55 | 66 |
| Ryzen AI Max+ 395, prefill (tok/s) | 1 641 | 1 213 | 807 | 1 631 |
| Ryzen AI Max+ 395, mémoire (Go) | 16 | 23 | 20 | 26 |
Sur le M5 Max, le décodage atteint 1,56 fois les 118 jetons par seconde de Qwen3.6-35B-A3B et 1,72 fois les 107 de Gemma. Sur le Ryzen AI Max+ 395, 114 jetons par seconde représentent 1,7 fois les 67 de Qwen, le « jusqu'à 1,7x » cité par Liquid. Une utilisation mémoire de 15 à 16 Go se compare à 19 à 26 Go pour les autres.
Sur un seul NVIDIA B300, avec SGLang 0.5.22 en BF16, 1 024 jetons d'entrée et jusqu'à 256 jetons de sortie sous charge soutenue, le modèle dépasse 21K jetons de sortie par seconde à une concurrence de 1 024. Le graphique montre environ 12,6K pour Qwen3.6-35B-A3B, 11,3K pour Nemotron-3.5-Lightning et 8,7K pour Gemma. Les modèles se valent à faible concurrence, et LFM prend l'avantage à partir d'environ 64 à 128 requêtes simultanées.
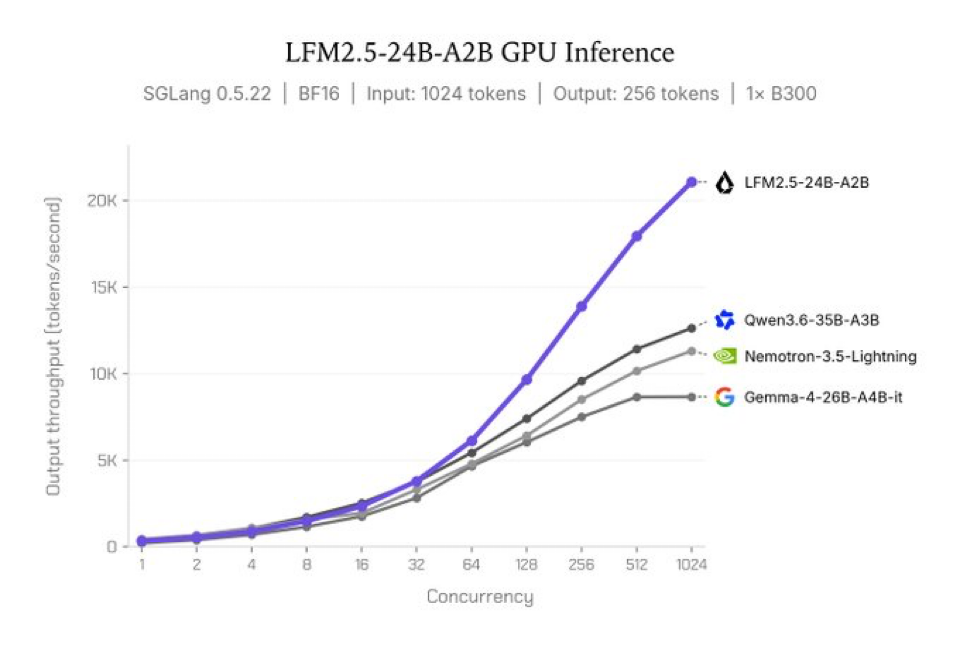 Tiré de l'article de blog de Liquid AI.
La prise en charge dès le premier jour couvre llama.cpp (GGUF), MLX, vLLM, SGLang et ONNX sur le matériel Apple, AMD, Qualcomm et NVIDIA.
Agents locaux et tarifs
Dans la démo de Liquid, LFM2.5-24B-A2B tourne dans Hermes Agent sur un MacBook Pro M5 Max : il planifie, appelle des outils et prépare un point matinal sur les modèles Hugging Face en tendance, avec des questions de suivi, sans aucun appel à une API dans le cloud. La boucle de répartition des outils prend bien moins d'une seconde par appel et, comme tout reste sur l'appareil, les données ne le quittent jamais et l'agent conserve des pistes d'audit complètes.
Les poids peuvent être téléchargés, affinés et déployés sans restriction, et Liquid qualifie le modèle de très facile à affiner. Pour un usage hébergé, l'API passe par Liquid Console avec un crédit de départ de 2 $, à 0,10 $ par million de jetons d'entrée (0,05 $ pour les entrées en cache) et 1,00 $ par million de jetons de sortie. Le modèle est aussi disponible dans le Playground de Liquid.
Contexte
LFM2.5-24B-A2B est le sommet d'une famille qui comprend LFM2.5-2.6B, le petit modèle que Liquid destinait aux agents locaux, et LFM2.5-VL-3B, son modèle vision-langage. Les modèles de décision Open d1 de Liquid s'appuient sur les deux. Nemotron-3.5-Lightning, l'un des modèles de comparaison ci-dessus, est présenté dans l'article sur Nemotron 3.5 Lightning de NVIDIA, et Pi et OpenCode, deux des harnais d'entraînement, figurent dans le benchmark de harnais de 8090 Labs.