
Moonshot AI a lancé Kimi K3.1 Pro, « notre modèle à poids ouverts de classe 3T le plus performant » : un mélange d'experts multimodal de 2,8T de paramètres au total dont 104B actifs, avec une fenêtre de contexte de 1M de tokens. Il est disponible sur Kimi.ai, Kimi Work, Kimi Code et l'API Kimi (platform.kimi.ai), aux côtés de K3.1 Pro Highspeed, 2 à 3 fois plus rapide. Les poids ouverts sont promis d'ici le 4 novembre 2026. Le blog technique donne les détails. Il fait suite à Kimi K3, dont les poids avaient été publiés 11 jours après son lancement de juillet, et conserve la taille de K3 : 2,8T au total, 104B actifs.
Ce que revendique Moonshot
- Codage de projets complets : des jeux sous Unreal, Unity et Godot.
- Modélisation 3D : modélisation 3D paramétrique dans Blender et en CAO.
- Finance : « plus fiable pour le travail financier », avec une modélisation précise et des hallucinations en baisse de 65 %.
- En général : « à la hauteur des modèles propriétaires les plus puissants sur les benchmarks de code, d'agents et de connaissances ».
Le graphique des benchmarks
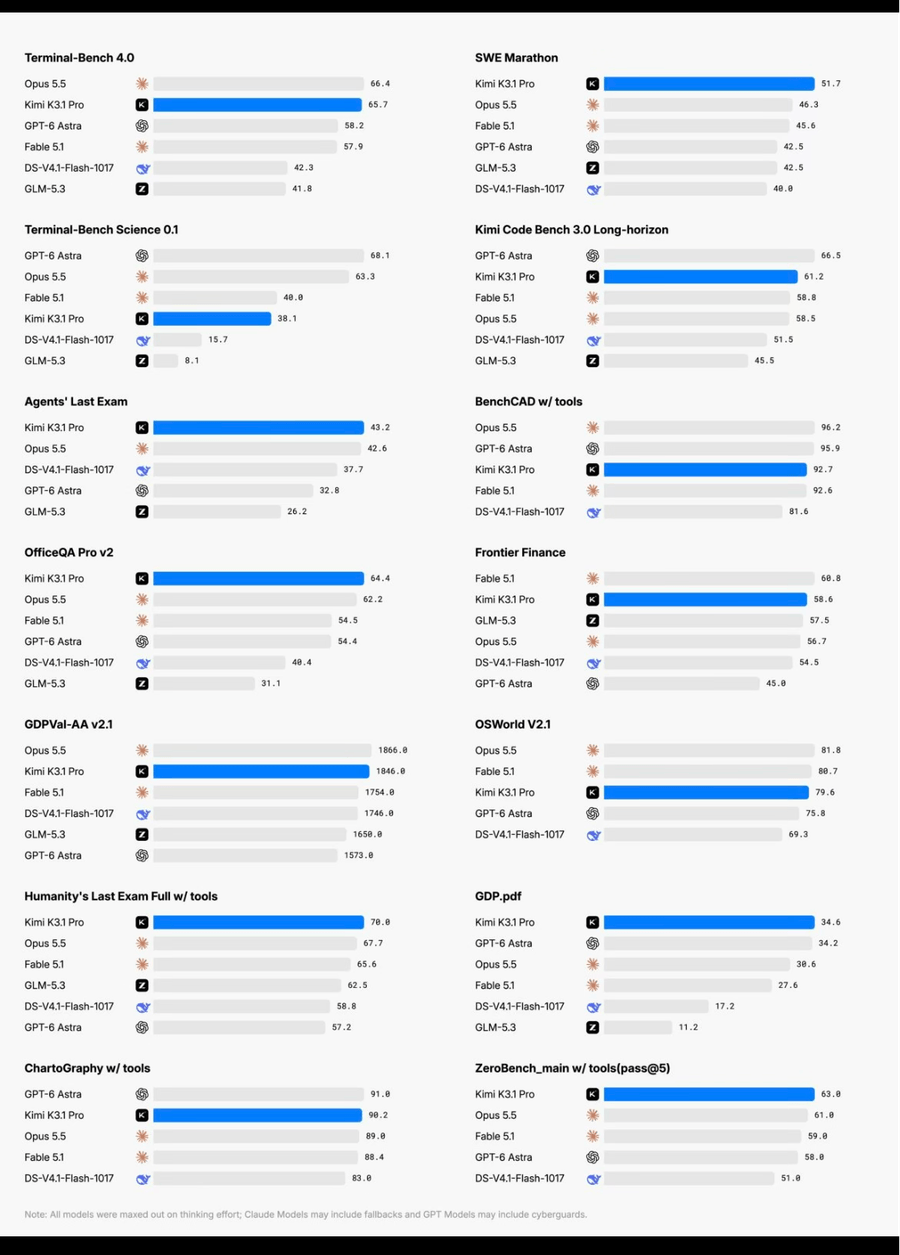 Graphique des benchmarks de Moonshot, tiré de l'annonce de Kimi K3.1 Pro. Tous les modèles ont été poussés au maximum de l'effort de réflexion ; les modèles Claude peuvent inclure des mécanismes de repli et les modèles GPT des garde-fous cyber.
| Benchmark | Kimi K3.1 Pro | Opus 5.5 | Fable 5.1 | GPT-6 Astra |
|---|---|---|---|---|
| SWE Marathon | 51.7 | 46.3 | 45.6 | 42.5 |
| Humanity's Last Exam, full, with tools | 70.0 | 67.7 | 65.6 | 57.2 |
| OfficeQA Pro v2 | 64.4 | 62.2 | 54.5 | 54.4 |
| Agents' Last Exam | 43.2 | 42.6 | — | 32.8 |
| GDP.pdf | 34.6 | 30.6 | 27.6 | 34.2 |
| ZeroBench (pass@5, with tools) | 63.0 | 61.0 | 59.0 | 58.0 |
| Terminal-Bench 4.0 | 65.7 | 66.4 | 57.9 | 58.2 |
| GDPVal-AA v2.1 (Elo) | 1846 | 1866 | 1754 | 1573 |
| ChartoGraphy, with tools | 90.2 | 89.0 | 88.4 | 91.0 |
| Kimi Code Bench 3.0 long-horizon | 61.2 | 58.5 | 58.8 | 66.5 |
| Frontier Finance | 58.6 | 56.7 | 60.8 | 45.0 |
| OSWorld V2.1 | 79.6 | 81.8 | 80.7 | 75.8 |
| BenchCAD, with tools | 92.7 | 96.2 | 92.6 | 95.9 |
| Terminal-Bench Science 0.1 | 38.1 | 63.3 | 40.0 | 68.1 |
Selon le décompte établi à partir du graphique, Kimi K3.1 Pro est premier sur 6 des 14 benchmarks, dans les deux premiers sur 11 et dans les trois premiers sur 13. En confrontation directe, il devance Opus 5.5 sur 9 lignes sur 14, GPT-6 Astra sur 10 sur 14 et Fable 5.1 sur 10 sur 13 (Fable n'a pas de barre pour Agents' Last Exam). Les marges des victoires sont faibles : 0,6 point sur Agents' Last Exam, 0,4 sur GDP.pdf face à GPT-6 Astra, 2,3 sur Humanity's Last Exam face à Opus 5.5. Il est derrière Opus 5.5 de 0,7 sur Terminal-Bench 4.0 et de 20 Elo sur GDPVal-AA.
Le seul point faible net est Terminal-Bench Science, où il obtient 38,1 contre 68,1 pour GPT-6 Astra et 63,3 pour Opus 5.5, soit la quatrième place sur six. Les deux autres modèles du graphique, V4.1 Flash de DeepSeek (version 1017) et GLM-5.3, restent derrière Kimi sur chacune des lignes où ils figurent (14 et 10 lignes). L'un des benchmarks, Kimi Code Bench 3.0, est celui de Moonshot elle-même. Voir aussi les articles consacrés à Opus 5.5, Fable 5.1, GPT-6 Astra et DeepSeek V4.1 Flash.
L'Artificial Analysis Intelligence Index
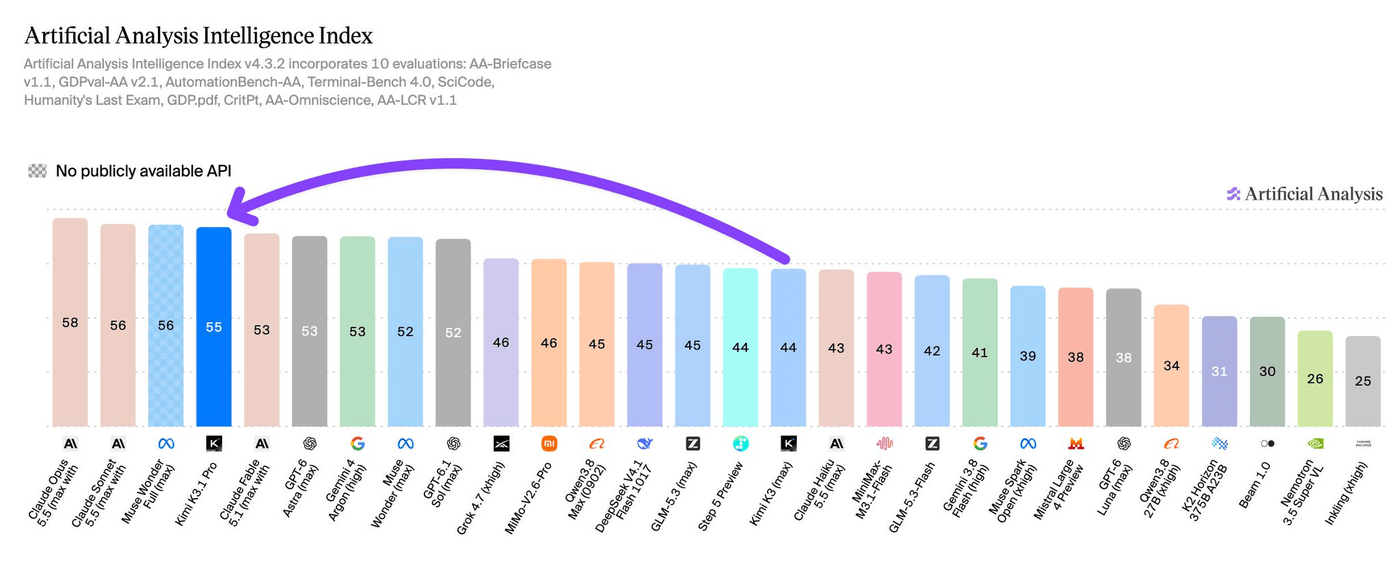 Artificial Analysis Intelligence Index v4.3.2, qui fait la moyenne de 10 évaluations : AA-Briefcase v1.1, GDPval-AA v2.1, AutomationBench-AA, Terminal-Bench 4.0, SciCode, Humanity's Last Exam, GDP.pdf, CritPt, AA-Omniscience et AA-LCR v1.1.
L'indice d'Artificial Analysis, réalisé par un tiers et non par Moonshot, place Kimi K3.1 Pro à 55, soit 11 points de plus que Kimi K3 (44, à effort maximal) et la quatrième place sur les 28 modèles du graphique. Seuls Claude Opus 5.5 (58), Claude Sonnet 5.5 (56) et Muse Wonder Full de Meta (56, présenté sans API publique) obtiennent un meilleur score. Il devance Claude Fable 5.1, GPT-6 Astra et Gemini 4 Argon (tous à 53), ainsi que GPT-6.1 Sol et Muse Wonder (52). Parmi les modèles dotés d'une API publique, il est troisième, à moins de trois points du sommet.
Les poids de Moonshot, une fois publiés le 4 novembre, se placeraient nettement au-dessus des modèles à poids ouverts de ce graphique : 9 points au-dessus de MiMo-V2.6-Pro (46), 10 au-dessus de DeepSeek V4.1 Flash 1017 (45) et 16 au-dessus de Muse Spark Open (39). Le recoupement de l'indice avec le graphique de Moonshot (GDPval-AA, Terminal-Bench 4.0, Humanity's Last Exam et GDP.pdf) correspond aux domaines où Kimi est le plus fort, tandis que sa faible performance sur Terminal-Bench Science n'y entre pas.