
Nanbeige a annoncé Nanbeige4.3-33B, en affirmant qu'il « offre des performances agentiques à l'état de l'art parmi les modèles ouverts d'environ 30B de paramètres », avec un modèle de base publié en parallèle. Nanbeige est l'équipe LLM de BOSS Zhipin. Selon la presse, le modèle compte 33,1B de paramètres, une fenêtre de contexte de 512K tokens et une licence Apache 2.0.
L'enseignant d'abord
Pour « repousser le plafond de performance des petits agents », Nanbeige explique que sa stratégie pour la série 4.3 commence par « construire d'abord un enseignant puissant ». Le modèle 33B joue ce rôle : il servira à entraîner les prochains modèles Nanbeige plus petits, à commencer par Nanbeige4.3-3B. C'est la même recette que celle de Meta pour Muse Glimmer, distillé à partir du modèle fermé Muse Spark. Nanbeige annonce de bons résultats sur les benchmarks de code agentique et de cowork, et affirme que, intégré aux principaux harnais d'agents, il vient à bout de tâches réelles avec une inférence économique.
Les benchmarks
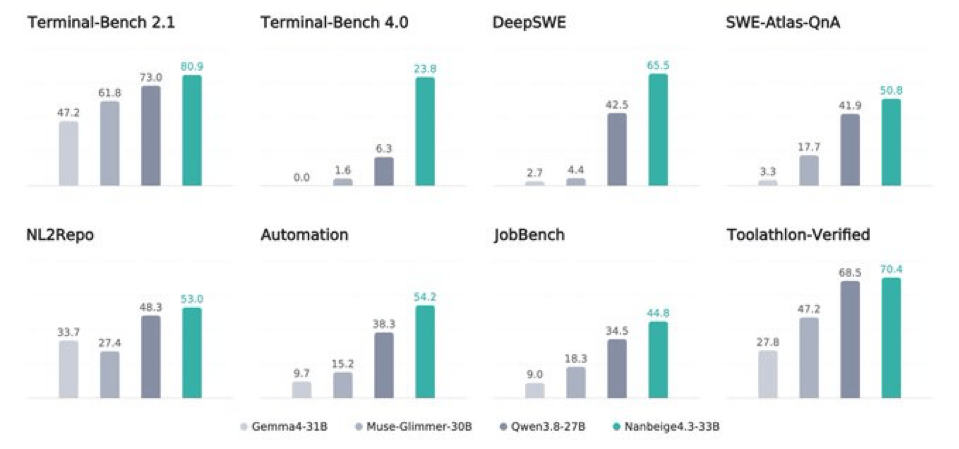 Comparaison des benchmarks tirée de l'annonce de Nanbeige.
| Benchmark | Nanbeige4.3-33B | Qwen3.8-27B | Muse Glimmer 30B | Gemma 4 31B |
|---|---|---|---|---|
| Terminal-Bench 2.1 | 80.9 | 73.0 | 61.8 | 47.2 |
| Terminal-Bench 4.0 | 23.8 | 6.3 | 1.6 | 0.0 |
| DeepSWE | 65.5 | 42.5 | 4.4 | 2.7 |
| SWE-Atlas-QnA | 50.8 | 41.9 | 17.7 | 3.3 |
| NL2Repo | 53.0 | 48.3 | 27.4 | 33.7 |
| Automation | 54.2 | 38.3 | 15.2 | 9.7 |
| JobBench | 44.8 | 34.5 | 18.3 | 9.0 |
| Toolathlon-Verified | 70.4 | 68.5 | 47.2 | 27.8 |
Nanbeige l'emporte sur les huit lignes, et la moyenne des huit scores atteint 55,4 contre 44,2 pour Qwen3.8-27B, 24,2 pour Muse Glimmer et 16,7 pour Gemma 4. Les écarts avec Qwen3.8-27B sont étroits sur Toolathlon-Verified (1,9 point) et NL2Repo (4,7) et larges sur les lignes agentiques les plus difficiles : Terminal-Bench 4.0 est 3,8 fois plus élevé (23,8 contre 6,3), DeepSWE affiche 23 points d'avance et Automation 15,9 points d'avance. Sur Terminal-Bench 4.0, les deux autres concurrents obtiennent des scores proches de zéro : cette ligne révèle donc un véritable écart sur le travail de terminal à long horizon, et pas seulement une avance sur des lignes où tout le monde réussit bien. Le graphique est celui de Nanbeige, la presse note qu'aucun tiers n'a reproduit les chiffres, et la réaction de la communauté sur les forums chinois a mis en doute que les résultats aient été ajustés aux benchmarks. Pour un autre modèle de code local rapide ce mois-ci, voir Flint de Recursive.