
Liquid AI a présenté LFM3, « notre nouvelle génération de Liquid Foundation Models », conçue pour la spécialisation et le déploiement sur appareil. Avec une nouvelle architecture tri-hybride et de nouveaux encodeurs multimodaux, elle se décline en six instances couvrant le texte, l'audio, la vision et l'omni, des modèles génératifs comme des modèles de décision, toutes construites sur LFM3-1.7B-Base et chacune affinable sur un seul GPU. La bibliothèque de modèles les recense et le fil de Liquid AI a annoncé le lancement.
L'architecture
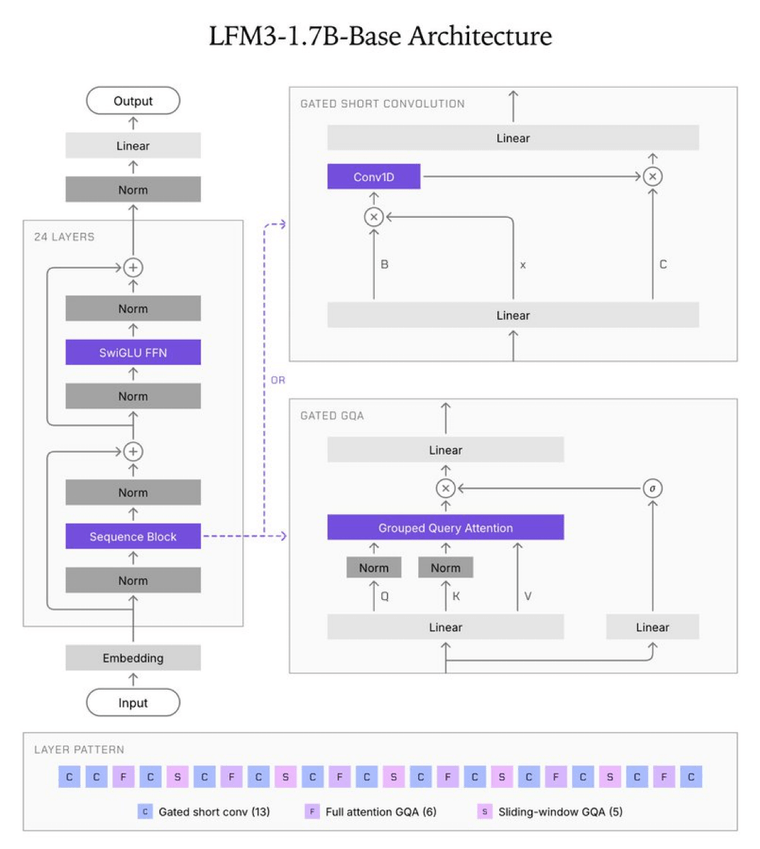 Architecture de LFM3-1.7B-Base, d'après l'annonce de Liquid AI.
La conception tri-hybride combine des convolutions courtes à portes, une attention à fenêtre glissante et une attention globale : 24 couches, dont 13 de convolution courte à portes, 6 de GQA à attention complète et 5 de GQA à fenêtre glissante. Liquid AI l'a trouvée grâce à sa recherche d'architecture propriétaire avec le matériel dans la boucle, qui note la qualité du modèle en tenant compte de la vitesse d'inférence et de l'utilisation mémoire mesurées sur le matériel cible. La recherche de LFM2 portait sur les processeurs de téléphones et d'ordinateurs portables ; celle de LFM3 couvre 14 combinaisons d'appareils et de backends, dont le Galaxy S26 Ultra, l'OnePlus 15, l'Apple M4 Max, AMD Ryzen AI, un Raspberry Pi 5, des CPU cloud Arm et x86, des GPU et le NPU Qualcomm Hexagon.
Les six modèles
- LFM3-1.7B (texte, 256K de contexte) : surpasse LFM2.5-2.6B avec 35 % de paramètres en moins, et ses poids tiennent dans environ 1 Go en 4 bits. Il est post-entraîné dans des environnements d'agents tels que Hermes Agent, Pi et OpenClaw, et devance Qwen3.5-9B sur WebArena-Verified et AutomationBench. À 128K tokens, son cache KV pèse 1,6 Go, contre 4,3 Go pour Qwen3.5-4B. Pour démontrer le passage à l'échelle, Liquid AI a exécuté plus de 300 000 agents LFM3-1.7B en parallèle sur l'archive d'e-mails d'Enron.
- LFM3-VL-2B (1,9B, vision-langage) : entrée vidéo, raisonnement pas à pas et compréhension spatiale. Il obtient en moyenne 71,4 sur 62 benchmarks de vision, au niveau de Gemma 4 12B, six fois plus grand, et Liquid AI le juge compétitif face à Gemini 3.5 Flash Lite et GPT-5.6 Luna. Son nouvel encodeur de vision maison utilise environ un tiers du calcul de SigLIP2.
- LFM3-Audio-2B : texte ou audio en entrée, texte, parole ou les deux en sortie, en 18 langues, avec appels d'outils. Un encodeur audio causal traite le signal du microphone pendant que l'utilisateur parle. Il obtient 58,5 à l'évaluation d'appel d'outils parlé de Liquid AI contre 44,3 pour Qwen2.5-Omni-3B, et le tokenizer LiquidCodec convertit les tokens en parole à environ 87 fois le temps réel sur un seul thread de CPU Apple M4 Max.
- LFM3-Omni-2B (2,2B) : le premier modèle omni, qui associe vision, audio et langage. Il obtient 70,1 sur Daily-Omni contre 61,3 pour Qwen2.5-Omni-7B.
- d1-2B et d1-Omni-2B : des modèles de décision qui répondent à plusieurs questions sur une même entrée en une seule passe avant, avec des probabilités calibrées (la version Omni ajoute l'audio). De nouveaux types de sorties couvrent les boîtes englobantes et les comptages, l'extraction de texte, de nombres et de dates avec les passages sources (ou « introuvable »), les estimations numériques assorties d'une plage, et les réponses à choix multiples avec des probabilités par option. Sur l'indice de 117 benchmarks de Liquid AI, d1-2B obtient 63,2 contre 58,8 pour d1-3B, avec un tiers de paramètres en moins. Voir le lancement de d1.
Résultats de vitesse et d'affinage
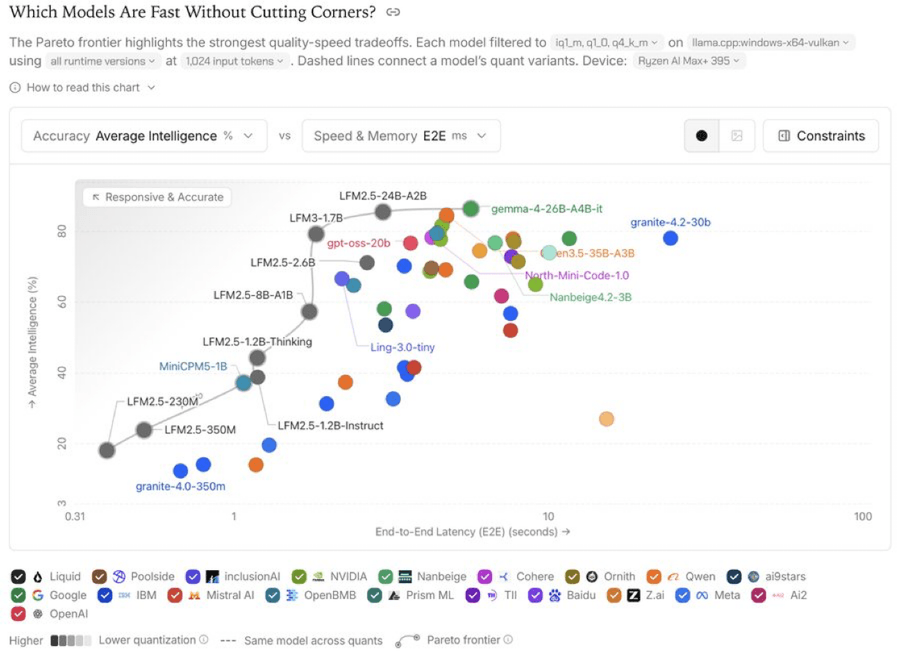 Graphique de Pareto qualité-vitesse pour les modèles sur appareil (Ryzen AI Max+ 395, llama.cpp, Vulkan, 1 024 tokens en entrée), issu de l'outil pipette de Liquid AI tel que présenté dans l'annonce.
Liquid AI affirme que LFM3-1.7B occupe la première place de la frontière de Pareto de l'intelligence sur appareil dans son benchmark pipette.liquid.ai. Sur le graphique, il se situe à environ 80 % d'intelligence moyenne en moins de 2 secondes de bout en bout, devant le plus grand LFM2.5-24B-A2B, à environ 86 % en 3 secondes environ, et Gemma 4 26B-A4B, proche de 87 % en 6 secondes environ, des valeurs lues approximativement sur le graphique.
Pour la spécialisation, Liquid AI a affiné LFM3-VL-2B sur environ 3 000 photos publiques de pales d'éoliennes avec SFT et GRPO, en quelques heures sur un seul A100. Sur environ 1 400 photos mises de côté, la précision de classification des défauts a atteint 67 %, contre moins de 10 % pour le modèle non affiné comme pour GPT-6 Luna, et le F1 de détection est passé de 0,003 à 0,11, contre 0,01 pour GPT-6 Luna. En robotique, l'entreprise rapporte 53 % de réussite sur R2R et 43 % sur RxR en navigation dans des scènes inédites sous contrôle continu strict, ainsi qu'un VLA de manipulation entraîné sur 15 morphologies, qui atteint en moyenne 96,2 % sur les quatre suites LIBERO et 45,7 % sur les tâches de table RoboCasa-GR1, en générant des blocs d'actions en moins de 50 ms sur un Jetson AGX Orin.
Disponibilité
Les fiches de modèles sont sur Hugging Face : LFM3-1.7B, LFM3-VL-2B, LFM3-Audio-2B, LFM3-Omni-2B, d1-2B et d1-Omni-2B. Les partenaires de lancement dès le premier jour comprennent AMD, Arm, NVIDIA, OpenRouter, Qualcomm, Vercel, Ambarella et Intel, MacPaw, Mercedes-Benz et Shopify ayant testé avant la sortie, avec une prise en charge dans llama.cpp, MLX, Ollama, LM Studio, vLLM, SGLang, Unsloth et d'autres. Tous les benchmarks sont ceux de Liquid AI. Il fait suite à LFM2.5-2.6B et au modèle 24B-A2B publiés plus tôt ce mois-ci.