
Mirendil a présenté Fern, son premier modèle : « pré-entraîné à partir de zéro », avec une fenêtre de contexte pouvant atteindre 10M tokens. Fern 0.1, la première version, a été finalisée par un court cycle de post-entraînement, et « de nouvelles versions sortent fréquemment ». La fiche du modèle mentionne un modèle de base baptisé Mirendil-Base, de 0,1 à 0,5T de paramètres, acceptant du texte et du code en entrée, avec un accès « bientôt disponible ». Mirendil le présente comme « notre modèle le plus efficace, conçu pour des tâches agentiques ciblées et à haut volume ». Selon la presse, Mirendil a été fondée par d'anciens chercheurs d'Anthropic ; la société a levé 200 millions de dollars en amorçage pour une valorisation d'environ 1 milliard de dollars auprès d'Andreessen Horowitz et de Kleiner Perkins, avec la participation de NVIDIA, et serait en discussions pour une valorisation d'environ 5 milliards de dollars.
Pourquoi 10M tokens
L'argument de Mirendil tient en une formule, « le contexte, c'est de l'intelligence » : les capacités d'un modèle croissent avec la puissance de calcul, et ce calcul peut être investi dans les paramètres ou dans le contexte. Davantage de paramètres permettent de stocker plus de connaissances statiques et de soutenir des étapes de raisonnement plus sophistiquées, tandis qu'un contexte plus large permet au modèle d'exploiter davantage d'informations propres à la tâche : sa propre expérience passée, plus de spécifications, plus de documents et de code, plus de données examinées directement. L'architecture, l'entraînement et le déploiement de Fern peuvent prendre en charge jusqu'à 10M tokens à la fois, soit environ 23 Mo de code ou à peu près un demi-million de lignes, une base de code de l'ampleur de la bibliothèque Megatron-LM, ou encore des dizaines à des centaines de traces complètes d'agents, ou des jours de travail d'un agent.
La prédiction continue de s'améliorer avec le contexte
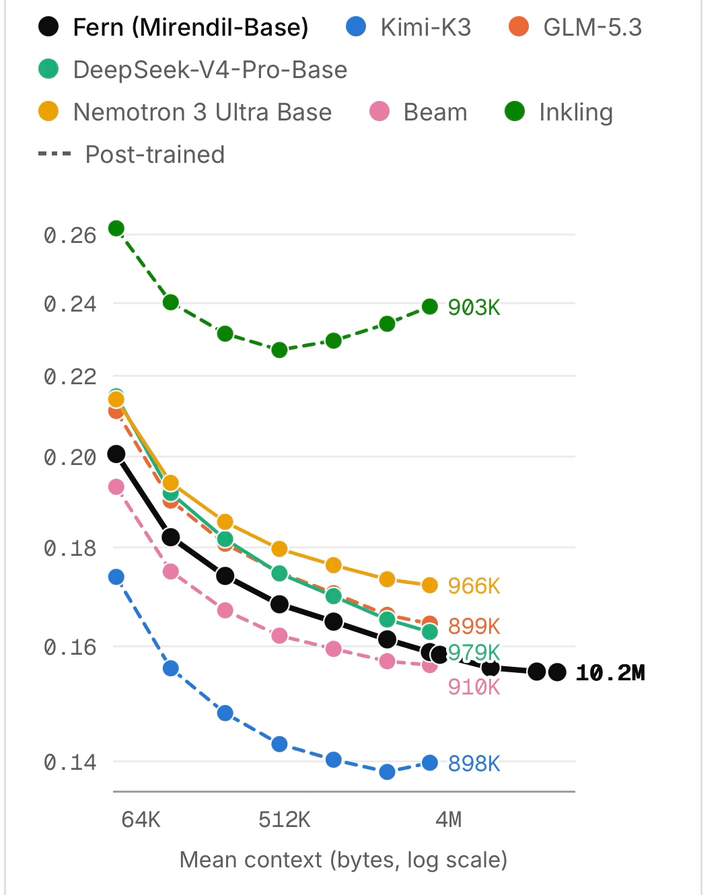 Entropie croisée en bits par octet sur les dépôts de Mirendil, tirée de l'annonce de Mirendil. Plus la valeur est basse, meilleur est le résultat ; les lignes en pointillés correspondent aux modèles post-entraînés.
Le premier test porte sur la simple prédiction du token suivant. Mirendil a concaténé ses dépôts en un flux unique de 42,9 Mo et l'a lu à l'aide de fenêtres glissantes se chevauchant, en mesurant le contexte en octets afin de comparer équitablement des modèles dotés de tokeniseurs différents. La perte de Fern passe d'environ 0,20 bit par octet pour un contexte d'environ 64K octets à environ 0,155 à 10,2M tokens, en continuant de s'aplatir doucement plutôt que de remonter. Les autres modèles ont été évalués jusqu'à environ 1M tokens, soit leur fenêtre annoncée au maximum ou davantage, tandis que Fern se poursuit jusqu'à une fenêtre de 23 Mio. Face aux modèles de base, la courbe de Fern se situe sous celles de DeepSeek-V4-Pro-Base (environ 0,163 pour la fenêtre la plus longue) et de Nemotron 3 Ultra Base (environ 0,172). Elle se situe au-dessus de Kimi-K3, qui obtient le score le plus bas du graphique, environ 0,14, bien que Kimi-K3 soit post-entraîné, tout comme GLM-5.3, Beam et Inkling, qui, selon Mirendil, obtiennent généralement des scores légèrement moins bons en bits par octet que leurs versions de base.
Retrouver l'information : RULER
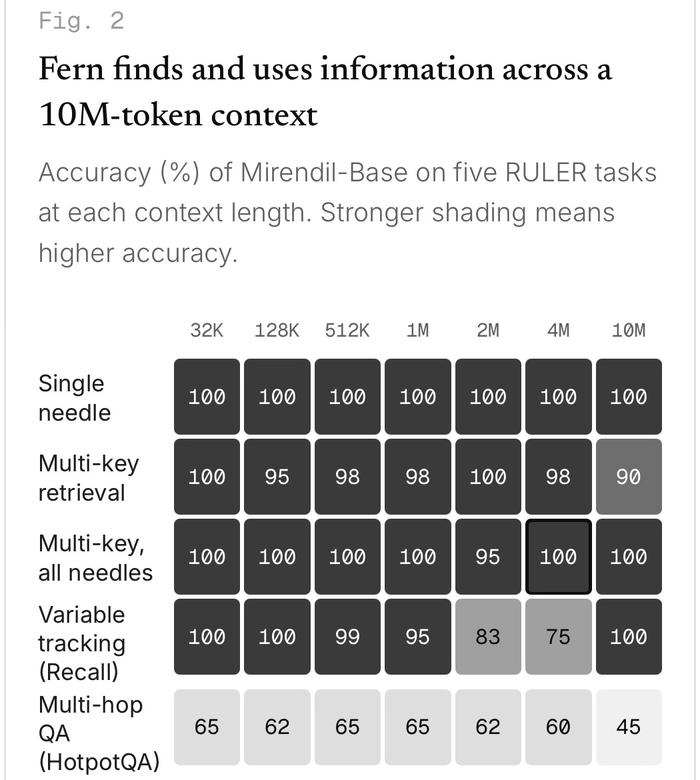 Précision (%) de Mirendil-Base sur cinq tâches RULER, tirée de l'annonce de Mirendil. Chaque cellule est la moyenne de 100 exemples (20 à 10M), avec décodage glouton, réflexion désactivée et correspondance exacte des chaînes de caractères.
Pour évaluer de façon élémentaire l'accès au long contexte, Mirendil soumet le modèle de base à RULER. La récupération d'une aiguille unique atteint 100 % à toutes les longueurs jusqu'à 10M tokens, la récupération multi-clés est de 90 % à 10M (de 98 % à 100 % de 512K à 4M) et la récupération de toutes les aiguilles reste à 95 % ou plus. Le suivi de variables recule à 83 % à 2M et à 75 % à 4M, mais atteint 100 % à 10M, la cellule qui ne repose que sur 20 exemples. Les questions-réponses multi-sauts (HotpotQA) constituent le point faible : de 60 % à 65 % jusqu'à 4M et 45 % à 10M, contre 65 % à 32K. La moyenne sur les cinq tâches passe de 93,0 à 32K à 87,0 à 10M, sous l'effet de cette dernière ligne. Mirendil indique que des résultats plus complets sur le long contexte sont à venir.
À quoi sert Fern
Mirendil positionne Fern sur le travail agentique ciblé des personnes qui construisent de l'IA : travailler sur des bases de code plus vastes, programmer de façon agentique en exécutant des commandes et en poursuivant jusqu'à ce que les tests passent, écrire du code de recherche tel que des boucles d'entraînement et des pipelines de données, déboguer un entraînement à partir de longs journaux et de traces d'appels, lire de bout en bout des traces complètes d'agents ou d'entraînement, et auditer un shard de pré-entraînement entier à la recherche de doublons, de contamination des benchmarks et de contenu inutile. Pour une autre sortie long contexte ce mois-ci, voir Kimi K3.1 Pro, dotée d'une fenêtre de 1M tokens.