
Aleph Alpha a présenté Parsy, « notre solution d'analyse de documents à l'état de l'art », un modèle spécialisé qui obtient 87,9 sur ParseBench contre 86,0 pour le harnais agentique qui l'a formé. Il analyse des centaines de milliers de pages par jour sur un seul H100, coûte un à deux ordres de grandeur de moins par page que le harnais, et alimente désormais le travail d'extraction des solutions clients d'Aleph Alpha ainsi que la mise en évidence des sources dans ses applications de chat. L'article de blog est signé Alex Sheldrick, Lukas Tatge et Mohamed Yassine Elkhadiri.
Pourquoi il a été conçu
Les ingénieurs déployés chez les clients d'Aleph Alpha ont constaté à de nombreuses reprises, dans des projets industriels et du secteur public, que des réponses erronées provenaient de l'analyse des documents. Les fiches techniques, manuels de maintenance, formulaires et rapports d'essai regorgent de tableaux imbriqués, de notes de bas de page, de graphiques et de scans, et les analyseurs essayés retrouvaient chaque mot et chaque nombre d'un tableau mais perdaient la correspondance entre une valeur, son unité et sa ligne, inventaient des caractères ou rattachaient des notes de bas de page au mauvais passage. Les clients avaient aussi besoin que les documents restent dans leur propre environnement, sur site ou dans un cloud privé, et aucun outil ne répondait à la fois à l'exigence de qualité et à celle de souveraineté.
Du harnais au modèle
La première version était un harnais agentique qui reconstruit chaque page à partir des éléments extraits, chacun accompagné d'une boîte englobante, puis demande à un modèle de vision de comparer la reconstruction à la page d'origine. Un modèle juge ne valide que les pages ayant un score de similarité élevé, ré-extrait les autres et envoie les pages incertaines à un relecteur humain facultatif. Sur ParseBench, un benchmark public de 2 078 pages vérifiées par des humains et issues de documents d'entreprise réels, il a obtenu 86,0 dans l'évaluation propre à Aleph Alpha, ce qui l'aurait placé premier du classement public jusqu'à la fin août 2026. Mais l'exécution de plusieurs modèles et de jusqu'à trois passes par page était trop lente et trop coûteuse pour des clients traitant des millions de pages par mois.
Aleph Alpha a donc utilisé le harnais pour annoter des données d'entraînement et affiné son propre modèle, dans le but d'égaler le harnais en une seule passe :
- Données : des documents publics ressemblant à ceux des clients, collectés dans le respect des exigences légales, sans aucune donnée client. Les annotations associent chaque élément à sa catégorie, sa boîte englobante et sa position dans l'ordre de lecture.
- Nettoyage : un modèle de mise en page indépendant, un contrôle de couverture d'encre pour détecter le texte omis et un second modèle d'OCR ont signalé les annotations suspectes, et des personnes ont échantillonné les signalements de chaque détecteur avant que le type d'erreur ne soit corrigé ou supprimé dans tout le corpus. Une correction concernait les longues listes et les tableaux où plusieurs lignes imprimées avaient été fusionnées dans une seule boîte.
- Résultat : la première version obtenait environ deux points de moins que le harnais sur ParseBench, l'a dépassé à la sixième des douze rondes d'entraînement, en passant de 84,0 à 87,9, et est restée au-dessus depuis. Aleph Alpha indique que les rondes suivantes apportent peu, car les erreurs restantes relèvent surtout de conventions de mise en forme. Elle précise aussi que repasser la sortie de Parsy dans le juge du harnais abaisse son score.
Les résultats
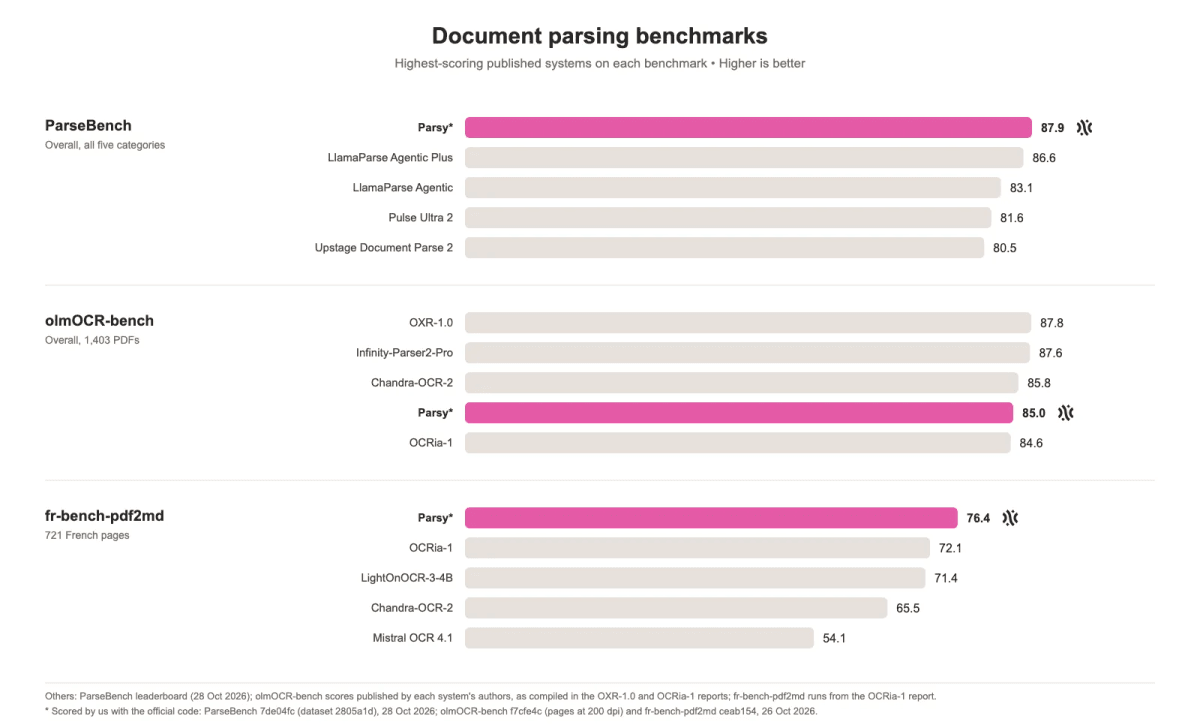 Parsy face aux systèmes publiés les mieux classés sur trois benchmarks, d'après l'article de blog d'Aleph Alpha. Scores de Parsy signalés par Aleph Alpha comme mesurés avec le code officiel de chaque benchmark.
- ParseBench : 87,9 sur l'ensemble des cinq catégories, devant LlamaParse Agentic Plus à 86,6 selon les chiffres publiés, puis LlamaParse Agentic à 83,1, Pulse Ultra 2 à 81,6 et Upstage Document Parse 2 à 80,5. Parsy ne figure pas dans le classement public, qui couvre les API en libre-service.
- fr-bench-pdf2md (721 pages françaises difficiles) : 76,4, premier, devant OCRia-1 à 72,1, LightOnOCR-3-4B à 71,4, Chandra-OCR-2 à 65,5 et Mistral OCR 4.1 à 54,1.
- olmOCR-bench (1 403 PDF) : 85,0, quatrième et à moins de trois points du meilleur : OXR-1.0 à 87,8, Infinity-Parser2-Pro à 87,6, Chandra-OCR-2 à 85,8, avec OCRia-1 à 84,6 juste derrière.
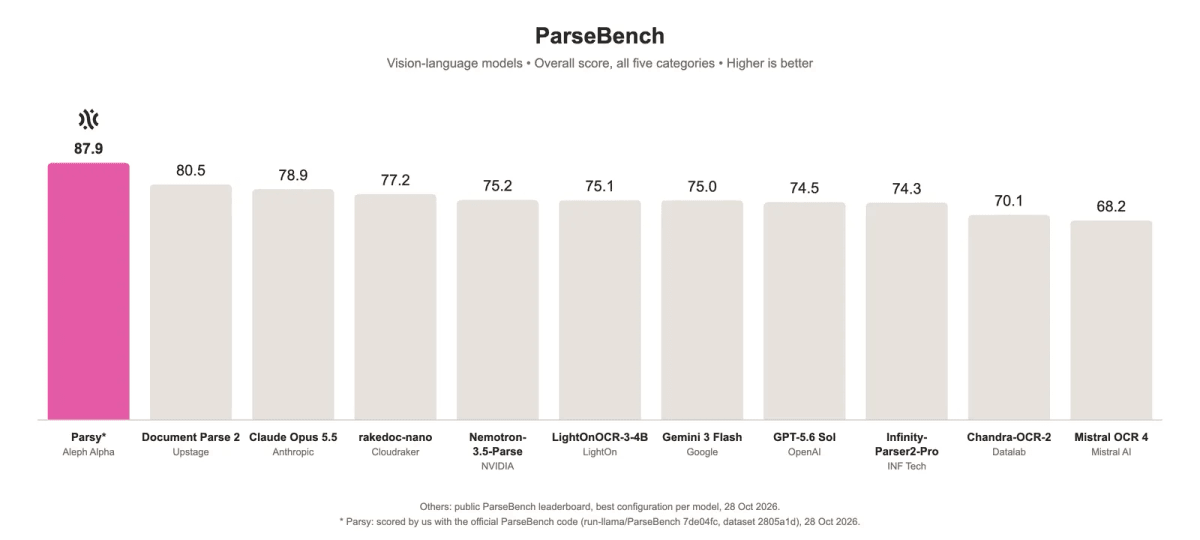 Score global ParseBench parmi les modèles vision-langage, meilleure configuration par modèle, d'après l'article d'Aleph Alpha.
La plupart des meilleurs systèmes sur ParseBench sont des pipelines qui exécutent plusieurs modèles et plusieurs passes par page, alors que Parsy est un modèle unique travaillant en une seule passe. Parmi les modèles vision-langage, le suivant est Document Parse 2 d'Upstage à 80,5, soit 7,4 points sous Parsy, avec Claude Opus 5.5 à 78,9, Gemini 3 Flash à 75,0 et GPT-5.6 Sol à 74,5.
Reproduire ParseBench
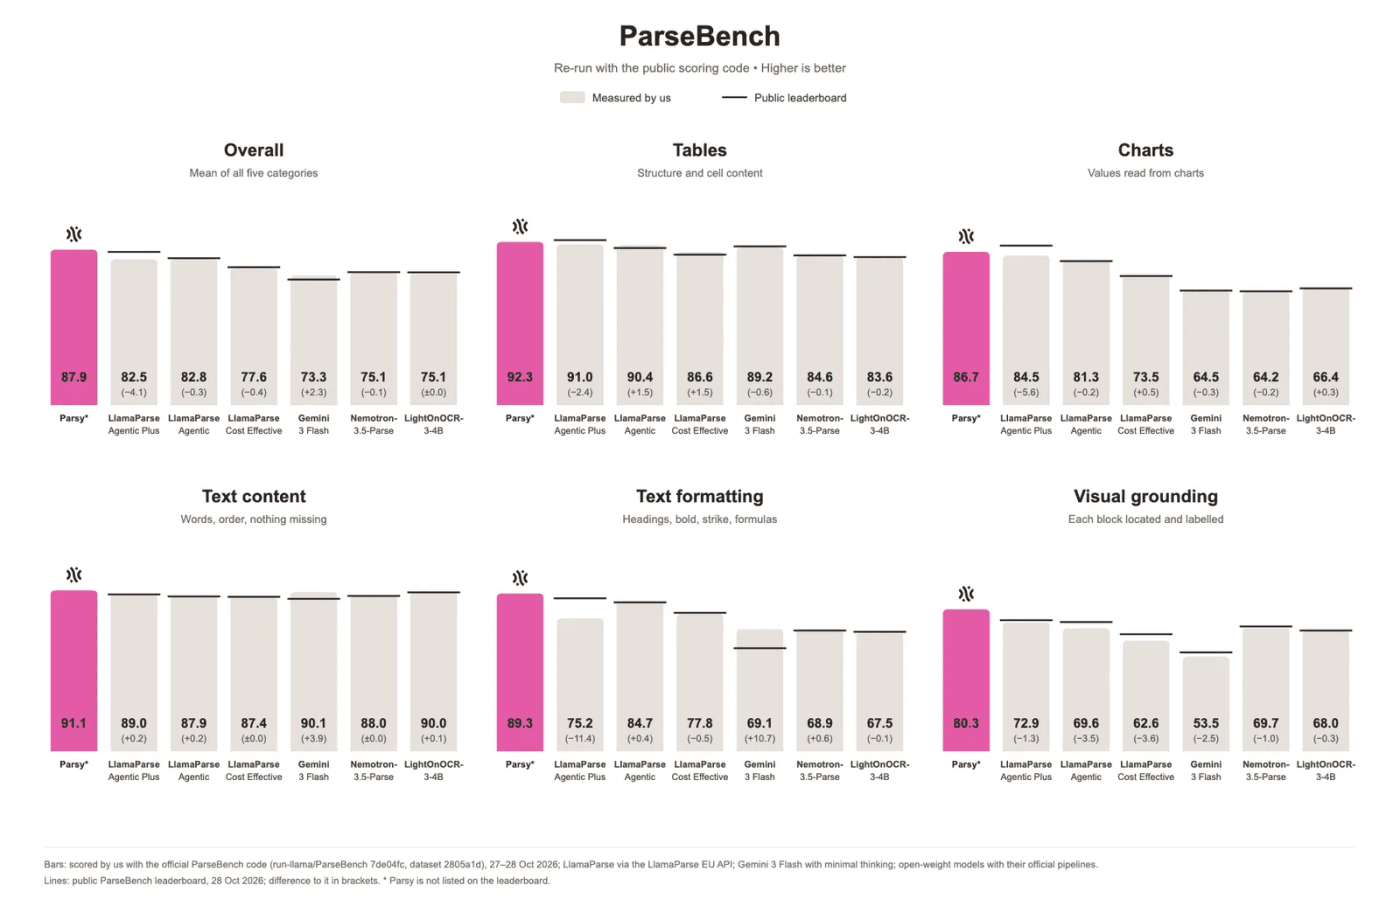 ParseBench réexécuté avec le code de notation public les 27 et 28 octobre, barres mesurées par Aleph Alpha et lignes issues du classement public, d'après son article.
Aleph Alpha indique avoir trouvé une vérité terrain douteuse sur 145 pages de ParseBench et avoir partagé avec les mainteneurs un visualiseur interactif contenant 316 cas clairs ; ceux-ci préparent une version corrigée du jeu de données. Elle a aussi réexécuté Parsy, les trois pipelines LlamaParse, Gemini 3 Flash, Nemotron-3.5-Parse et LightOnOCR-3-4B avec le code de notation public. Les modèles à poids ouverts correspondaient à leurs entrées du classement à environ un point près, mais les pipelines LlamaParse n'y correspondaient pas au départ. LlamaIndex a attribué l'écart à des différences entre son évaluation interne et le pipeline public, et a actualisé les scores le jour même. LlamaParse Cost Effective et Agentic concordent désormais à un demi-point près, tandis qu'Agentic Plus reste environ quatre points au-dessus de la mesure d'Aleph Alpha (82,5 contre 86,6 dans le classement), surtout sur la mise en forme et les graphiques, et les deux sociétés examinent la question. Dans les exécutions d'Aleph Alpha, Parsy est en tête dans les cinq catégories : tableaux 92,3, graphiques 86,7, contenu textuel 91,1, mise en forme du texte 89,3 et ancrage visuel 80,3.
Au-delà de l'analyse
Comme Parsy conserve une boîte englobante pour chaque élément, une réponse de chat peut indiquer la région exacte de la page source dont elle provient, affichée en surbrillance sur la page rendue plutôt que sous la forme d'un nom de document et d'un numéro de page. Une interface de relecture présente la page d'origine à côté de sa reconstruction, avec un score pour chaque page. Le débit dépend de la densité des pages, et les boîtes et la structure représentent environ un tiers de la sortie.
Disponibilité
Parsy est disponible dans le cadre des missions clients d'Aleph Alpha, comme une capacité que ses ingénieurs déployés chez les clients apportent aux projets, sans publication publique. Les chiffres des benchmarks sont ceux d'Aleph Alpha, notés avec le code officiel de chaque benchmark. Il fait suite à Kolibri-1, le modèle à poids ouverts de l'entreprise, et rejoint un domaine qui comprend Mistral OCR 4.1.