
Deep Principle a présenté Hydrogen-1.0, « notre premier modèle à poids ouverts pour la recherche scientifique », dans un fil de Chenru Duan. Les poids sont disponibles sur Hugging Face. Le modèle a été obtenu en post-entraînant GLM-5.3 sur des données propres à la chimie, à la science des matériaux et aux sciences de la vie, ainsi que sur des relevés et des trajectoires d'agents issus des laboratoires de l'entreprise. Selon Duan, il vise une « superintelligence scientifique ouverte pour la découverte », en soutenant que seuls les poids ouverts permettent aux chercheurs d'examiner les progrès de l'IA, de les adapter et de s'appuyer dessus.
Les chiffres
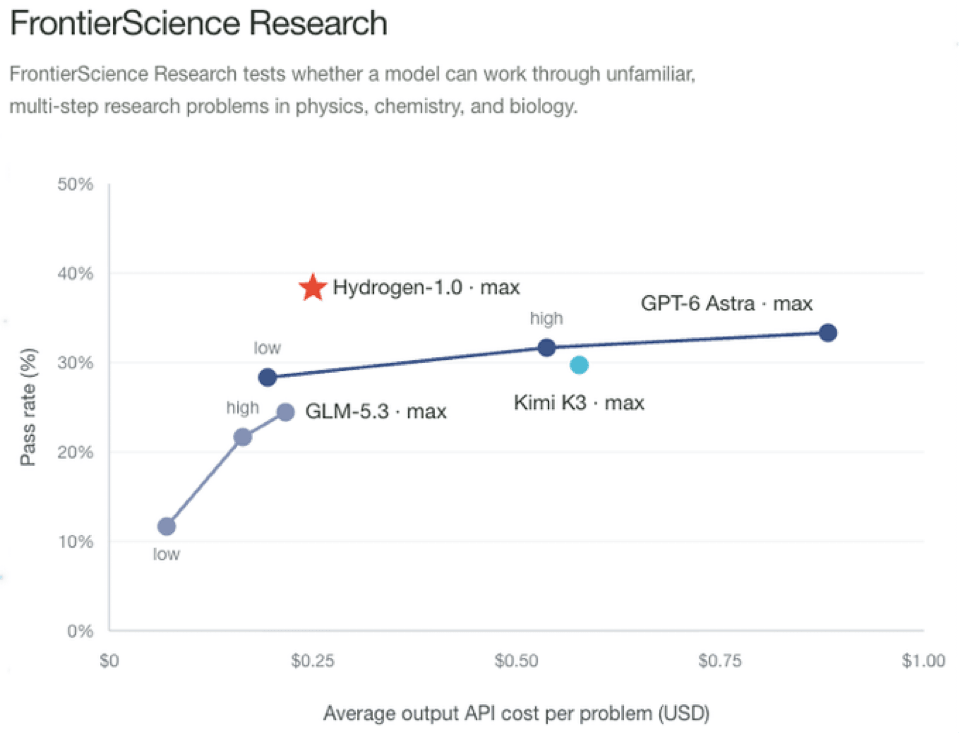 Taux de réussite sur FrontierScience Research en fonction du coût moyen d'API en sortie par problème, d'après l'article de blog de Deep Principle. Les valeurs des modèles autres qu'Hydrogen-1.0 sont lues sur le graphique et approximatives.
- FrontierScience-Research : 38,3 % contre 33,3 % pour GPT-6 Astra en réflexion maximale, sur ce test du benchmark portant sur des problèmes de recherche inédits et en plusieurs étapes en physique, en chimie et en biologie. Sur le graphique, Hydrogen-1.0 se situe au-dessus de tous les autres points pour environ un quart de dollar par problème, alors qu'Astra a besoin d'environ 88 cents pour son meilleur score. Kimi K3 se situe près de 30 % pour environ 58 cents et GLM-5.3 près de 24,5 % pour environ 21 cents.
- GPQA-Diamond : 93,0 %, que Deep Principle qualifie d'équivalent à l'état de l'art. L'entreprise indique que ce résultat améliore celui de GLM-5.3 et égale à peu près Kimi K3, pour un coût d'API similaire à celui de GLM-5.3.
- Scénarios de recherche internes : face à Astra en réflexion maximale, Hydrogen-1.0 obtient 76,9 % contre 71,8 % en calcul scientifique (5,13 points) et 90,5 % contre 85,7 % en prédiction de réactions directes en une étape (4,76 points), et reste devant pour chacun des trois niveaux de réflexion. Astra reste en tête en élucidation de structures par RMN, avec 30,0 % contre 26,7 %, soit 3,33 points d'écart. Deep Principle précise que les scores absolus de ces tâches reflètent la difficulté des cas et ne constituent pas des comparaisons de capacités.
- Conception de matériaux : dans la conception de complexes de métaux de transition, chaque modèle recommande de nouveaux complexes sur cinq tours à partir de la même population de départ, en ne voyant que les résultats de ses propres choix. Au cinquième tour, le gap HOMO-LUMO moyen du meilleur résultat obtenu jusque-là est de 4,318 eV pour Hydrogen-1.0, contre 3,689 eV pour Astra et 3,353 eV pour Kimi K3.
Ce qu'il fait
Les exemples de Deep Principle sont des flux de travail de recherche agentiques :
- Dynamique moléculaire : il écrit du Python pour construire un fondu de polyéthylène, lance GROMACS, détecte et corrige une erreur de topologie puis redémarre, avant d'analyser la trajectoire de 40 ns pour la densité, l'empilement, la diffusion et les dimensions des chaînes.
- Réseaux réactionnels : il cartographie un réseau de transposition d'Ireland-Claisen de 27 structures reliées par 30 réactions plausibles, avec des branches concurrentes et des chemins de retour.
- RMN : à partir de sept produits de monoformylation candidats du 2-bromonaphtalène et d'un spectre 1H, il examine les signaux déblindés et aromatiques pour évaluer chaque candidat.
- Planification d'expériences : entraîné sur des relevés de cahiers de laboratoire électroniques, où l'intention, la procédure, les observations et le résultat restent reliés, il transforme une intention d'une phrase en plan expérimental et en protocole.
Entraînement
L'entraînement associe un réglage fin supervisé sur des exemples travaillés de raisonnement, de planification d'expériences, de conception de protocoles et d'analyse de résultats à un apprentissage par renforcement fondé sur des retours concernant les résultats de recherche. Les données couvrent les connaissances du domaine, les retours des scientifiques sur les tâches, les relevés de laboratoire et des trajectoires de découverte complètes, y compris les tentatives ayant échoué. Le post-entraînement du modèle complet à mélange d'experts s'appuie sur Megatron et SGLang, sur NVIDIA CUDA comme sur AMD ROCm.
Deep Principle situe cette publication par rapport à des travaux de découverte propriétaires tels que la preuve de Navier-Stokes d'OpenAI et la découverte d'enzymes d'Anthropic, dont les modèles sous-jacents ne sont pas à poids ouverts. Tous les résultats proviennent des propres évaluations de Deep Principle, et les tâches internes ne sont pas publiques.