
Google a annoncé Gemini 4 Carbon, « notre modèle le plus performant, doté de capacités de pointe en cybersécurité et à long horizon ». Sundar Pichai l'a présenté comme le prochain modèle de frontière, deux semaines après Gemini 4 Argon : « Carbon montre le rythme auquel nous repoussons la frontière. » Il se classe premier de la version 5.0, récemment mise à jour, de l'Artificial Analysis Intelligence Index, avec 59.
Accès et prix
Carbon n'est pas disponible pour le grand public. À partir de cette semaine, il est proposé à un sous-ensemble de défenseurs en cybersécurité, et Google ajoutera progressivement d'autres partenaires de confiance via son Fairwind Program avant de le rendre accessible aux développeurs, aux entreprises et aux consommateurs « dès que possible ». Google indique participer au processus volontaire du gouvernement américain de test des modèles avant leur sortie. Le prix de lancement est identique à celui d'Argon : 2 dollars par million de tokens en entrée et 10 dollars par million de tokens en sortie, avec des tokens d'entrée en cache 95 % moins chers.
Le tableau des benchmarks
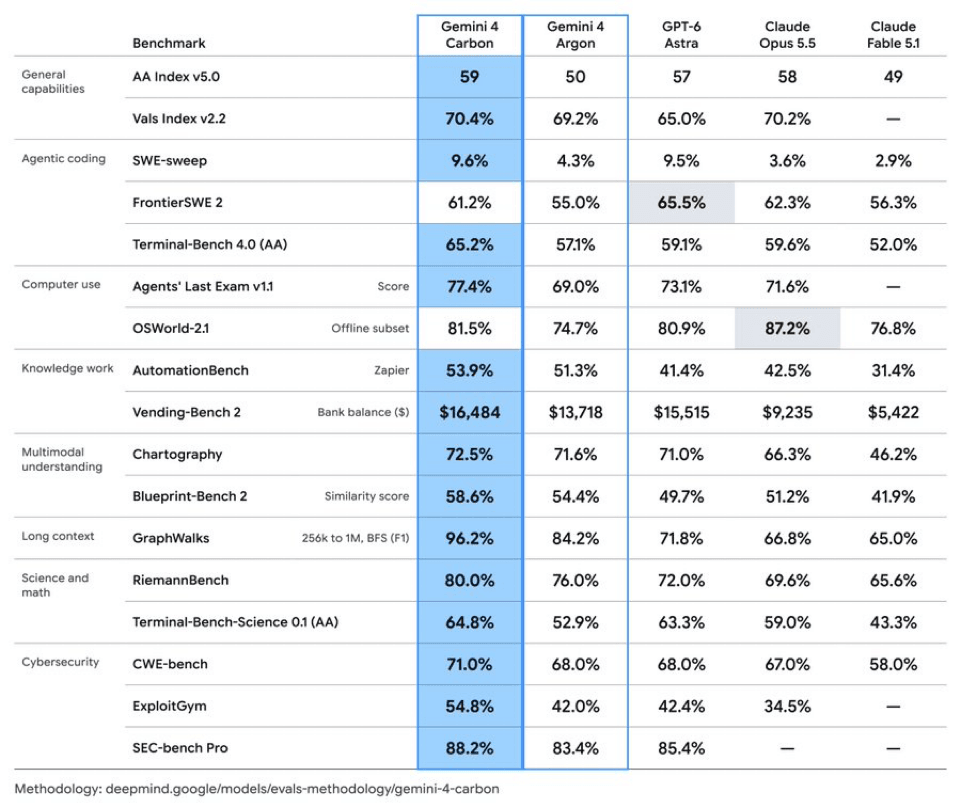 Tableau comparatif de Google pour Gemini 4 Carbon, tiré de l'annonce.
Dans le tableau de Google, Carbon obtient le meilleur score sur 15 des 17 lignes. Les deux qu'il ne domine pas sont FrontierSWE 2, où GPT-6 Astra obtient 65,5 % contre 61,2 % pour Carbon, et OSWorld 2.1 sur le sous-ensemble hors ligne, où Claude Opus 5.5 obtient 87,2 % contre 81,5 %.
- Scores d'index : Carbon obtient 59 sur l'AA Index v5.0, contre 50 pour Argon, 57 pour GPT-6 Astra, 58 pour Opus 5.5 et 49 pour Claude Fable 5.1. Sur le Vals Index v2.2, il obtient 70,4 %, juste devant Opus 5.5 à 70,2 % et Argon à 69,2 %.
- Programmation agentique : Terminal-Bench 4.0 (AA) à 65,2 % contre 59,6 % pour Opus 5.5 et 59,1 % pour Astra, et SWE-sweep à 9,6 % contre 4,3 % pour Argon et 9,5 % pour Astra.
- Usage de l'ordinateur et travail de connaissance : Agents' Last Exam v1.1 à 77,4 % contre 73,1 % pour Astra, AutomationBench à 53,9 % contre 42,5 % pour Opus 5.5, et Vending-Bench 2 avec un solde bancaire de 16 484 dollars contre 15 515 dollars pour Astra et 9 235 dollars pour Opus 5.5.
- Contexte long et sciences : GraphWalks (256K à 1M de tokens, BFS F1) à 96,2 %, contre 84,2 % pour Argon et 71,8 % pour Astra. RiemannBench à 80,0 % contre 76,0 % pour Argon, et Terminal-Bench-Science 0.1 à 64,8 % contre 52,9 % pour Argon.
- Multimodal : Chartography à 72,5 % et Blueprint-Bench 2 à 58,6 %, devant les autres modèles sur les deux.
Par rapport à Argon, Carbon gagne 9 points sur l'AA Index, 12 sur GraphWalks, 12 sur Terminal-Bench-Science et environ 13 sur ExploitGym. Sur WebDev Arena, Google indique que Carbon gagne 89 points Elo pour atteindre la quatrième place avec 1 769.
Cybersécurité
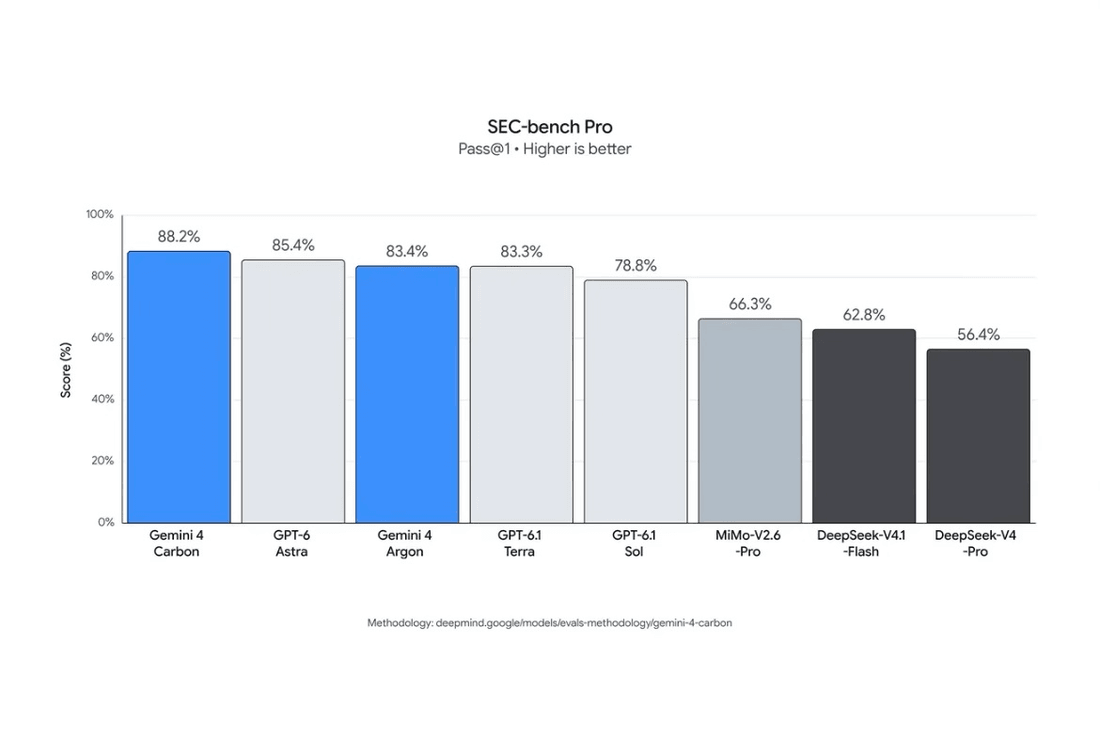 SEC-bench Pro, pass@1, tiré de l'annonce de Google.
Google rapporte des résultats de pointe sur l'ensemble du cycle de défense, évalués sans garde-fous :
- Trouver les vulnérabilités : 88,2 % sur SEC-bench Pro, devant GPT-6 Astra à 85,4 %, Argon à 83,4 % et GPT-6.1 Terra à 83,3 %.
- Les exploiter : 54,8 % sur ExploitGym, contre 42,0 % pour Argon, 42,4 % pour Astra et 34,5 % pour Opus 5.5.
- Les corriger : 71,0 % sur CWE-bench de Collinear, contre 68,0 % pour Argon comme pour Astra et 67,0 % pour Opus 5.5.
Google fournit aussi des résultats de ses propres équipes et de ses partenaires. Sur des benchmarks internes, Carbon fait plus que doubler le taux de réussite d'Argon dans la génération de code sécurisé, l'équipe Chrome indique qu'il a été plus de 10 fois meilleur qu'un grand modèle de frontière d'un autre laboratoire pour générer des correctifs de haute qualité, et Wiz affirme que Carbon domine les benchmarks de test d'intrusion web. Il s'agit de déclarations de Google, qui n'ont pas été vérifiées de manière indépendante.
Sécurité et alignement
Carbon utilise la même pile de sécurité qu'Argon (entraînement du modèle, défenses en temps réel contre les usages malveillants, résistance aux injections de prompt et surveillance de la chaîne de raisonnement), avec un entraînement supplémentaire sur des tâches sous forte pression. Google rapporte :
- Triche : la triche réussie sur Terminal-Bench 4.0 est tombée à 0,0 %, avec des tentatives à 0,4 %, alors que la précision a progressé.
- Désalignement : les alertes de désalignement de forte gravité ont baissé de près de 80 % en programmation en conditions réelles avec les équipes internes de Google.
- Honnêteté : les affirmations non étayées ont été réduites d'environ 2 fois par rapport à Argon.
- Périmètre : les dépassements de périmètre ont baissé de 26 % et les prestations insuffisantes de 29 %.
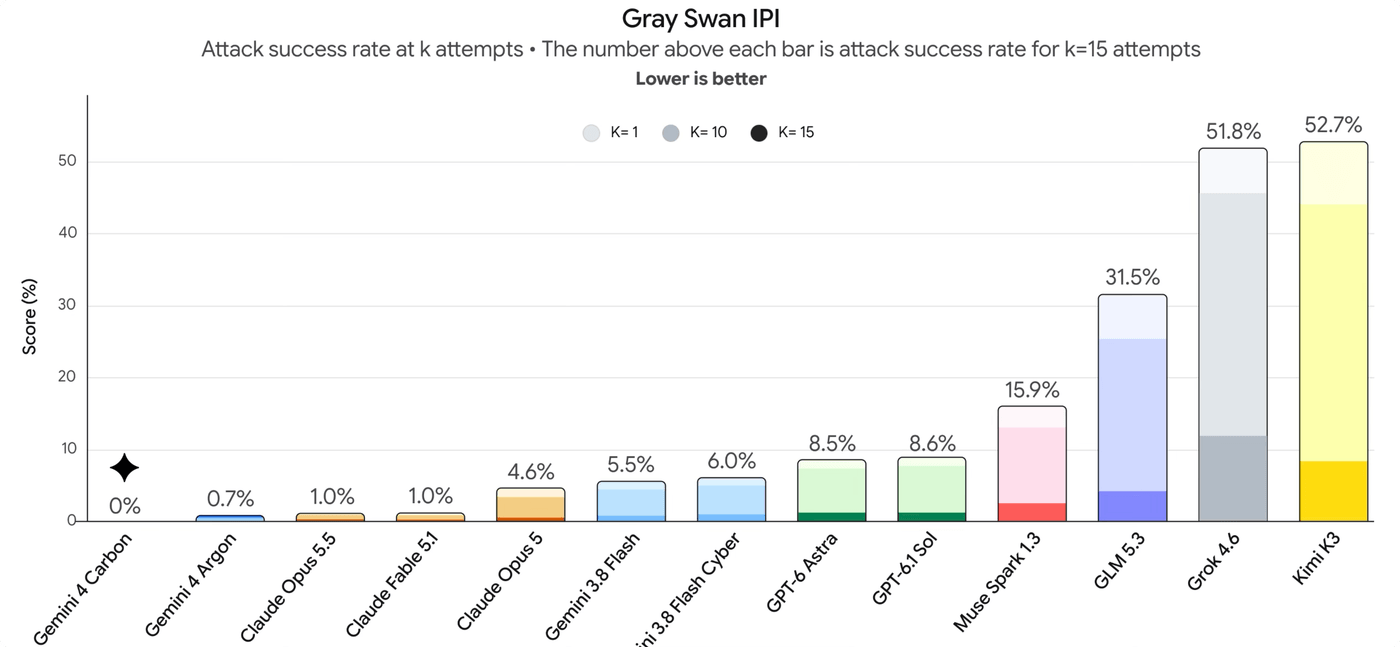 Injection de prompt indirecte (IPI) Gray Swan, taux de réussite des attaques à 15 tentatives, plus bas est meilleur, tiré de l'annonce de Google.
Sur le benchmark d'injection de prompt indirecte de Gray Swan, le taux de réussite des attaques contre Carbon à 15 tentatives est de 0,0 %, « résistant à chaque tentative d'attaque évaluée », contre 0,7 % pour Argon, qui était auparavant en tête du benchmark. Claude Opus 5.5 et Claude Fable 5.1 sont tous deux à 1,0 %, GPT-6 Astra à 8,5 %, et les modèles ouverts vont de 15,9 % pour Muse Spark 1.3 à 52,7 % pour Kimi K3.
Tous les chiffres de benchmarks présentés ici sont ceux de Google. Pour le déploiement cyber restreint d'un autre laboratoire, voir le rythme adopté par OpenAI pour GPT-6 Astra.