
Meituan a présenté LongCat-2.5, « notre tout dernier modèle agentique nativement multimodal, avec 1,6T de paramètres au total et ~48B actifs ». Il est conçu pour des tâches agentiques de longue haleine, avec « une compréhension visuelle renforcée et un codage agentique renforcé » pour des travaux allant des projets de code complexes au codage visuel, comme la conception créative et les tâches 3D. L'article de blog de Meituan prolonge LongCat-2.0 dans trois domaines : la vision native, l'apprentissage par renforcement agentique et l'infrastructure.
Les graphiques de benchmark
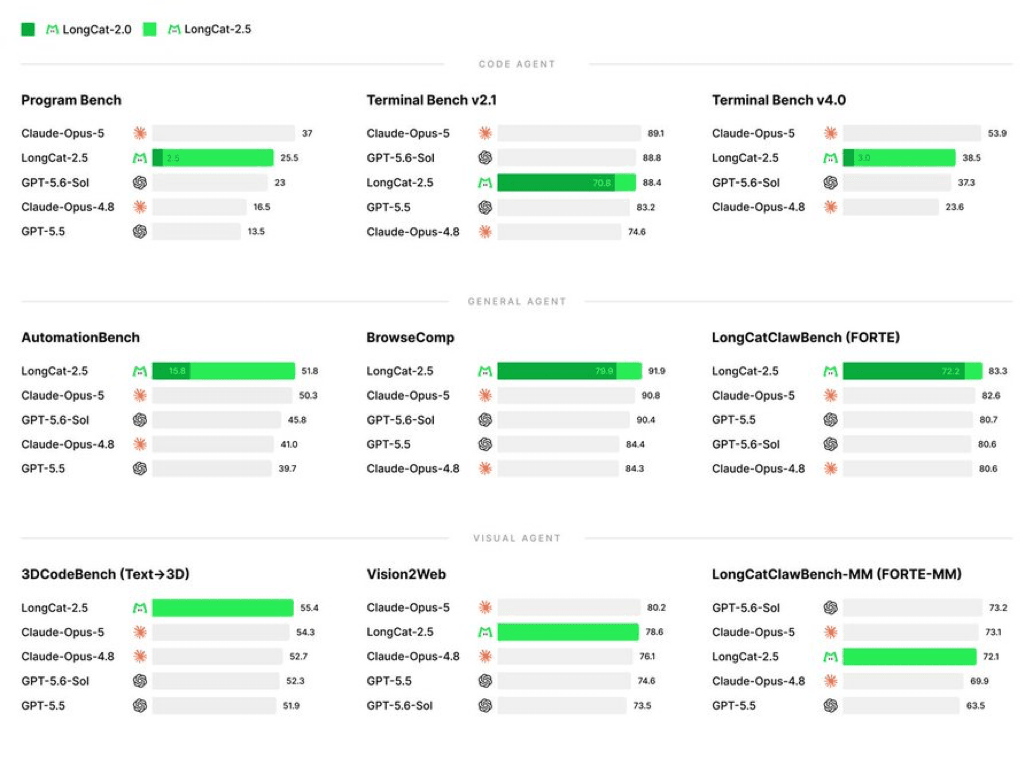 Les graphiques comparatifs de Meituan pour LongCat-2.5, tirés de son article de blog.
Meituan compare LongCat-2.5 à GPT-5.5, GPT-5.6 Sol, Claude Opus 4.8 et Claude Opus 5. Il arrive en tête sur quatre des neuf graphiques, en deuxième position sur trois et en troisième sur deux :
- Premier : AutomationBench à 51,8 (Opus 5 à 50,3), BrowseComp à 91,9 (Opus 5 à 90,8), LongCatClawBench (FORTE) à 83,3 (Opus 5 à 82,6), et 3DCodeBench (texte vers 3D) à 55,4 (Opus 5 à 54,3).
- Deuxième : Program Bench à 25,5 contre 37 pour Opus 5, Terminal Bench 4.0 à 38,5 contre 53,9 pour Opus 5, et Vision2Web à 78,6 contre 80,2 pour Opus 5.
- Troisième : Terminal Bench 2.1 à 88,4, juste derrière Opus 5 à 89,1 et GPT-5.6 Sol à 88,8, et LongCatClawBench-MM (FORTE-MM) à 72,1, derrière GPT-5.6 Sol à 73,2 et Opus 5 à 73,1.
Par rapport à son prédécesseur, six graphiques montrent LongCat-2.0 : AutomationBench passe de 15,8 à 51,8, Terminal Bench 4.0 de 3,0 à 38,5, Program Bench de 2,5 à 25,5, Terminal Bench 2.1 de 70,8 à 88,4, BrowseComp de 79,9 à 91,9 et LongCatClawBench de 72,2 à 83,3. L'article mentionne un tableau couvrant un plus large éventail de modèles, qui ne faisait pas partie des éléments disponibles ici. Tous les chiffres proviennent de Meituan.
La vision native sous forme de tokens
LongCat-2.5 représente les signaux visuels sous forme de tokens discrets à plusieurs niveaux, de sorte que le backbone traite les images et le texte dans un même format de tokens. Une quantification vectorielle résiduelle est appliquée aux caractéristiques en résolution native issues d'un Semantic-and-Aligned Encoder, comme dans LongCat-Next, et les identifiants de tokens sont précalculés hors ligne, ce qui retire l'encodeur visuel du graphe d'entraînement et rend la charge par modalité prévisible entre les rangs data-parallel. Les embeddings du codebook visuel sont appris conjointement avec le backbone. Dans une vérification préliminaire sur un MoE plus petit, avec environ 3B de paramètres actifs, les embeddings visuels et textuels s'entremêlent dans un espace partagé.
La vitrine de Meituan comprend huit démos générées de bout en bout par le modèle, telles qu'une simulation de fluides en temps réel, des expositions numériques en 3D, des dioramas de villes, des analyses d'entreprise et des invitations à des événements.
RL agentique et entraînement multi-enseignants
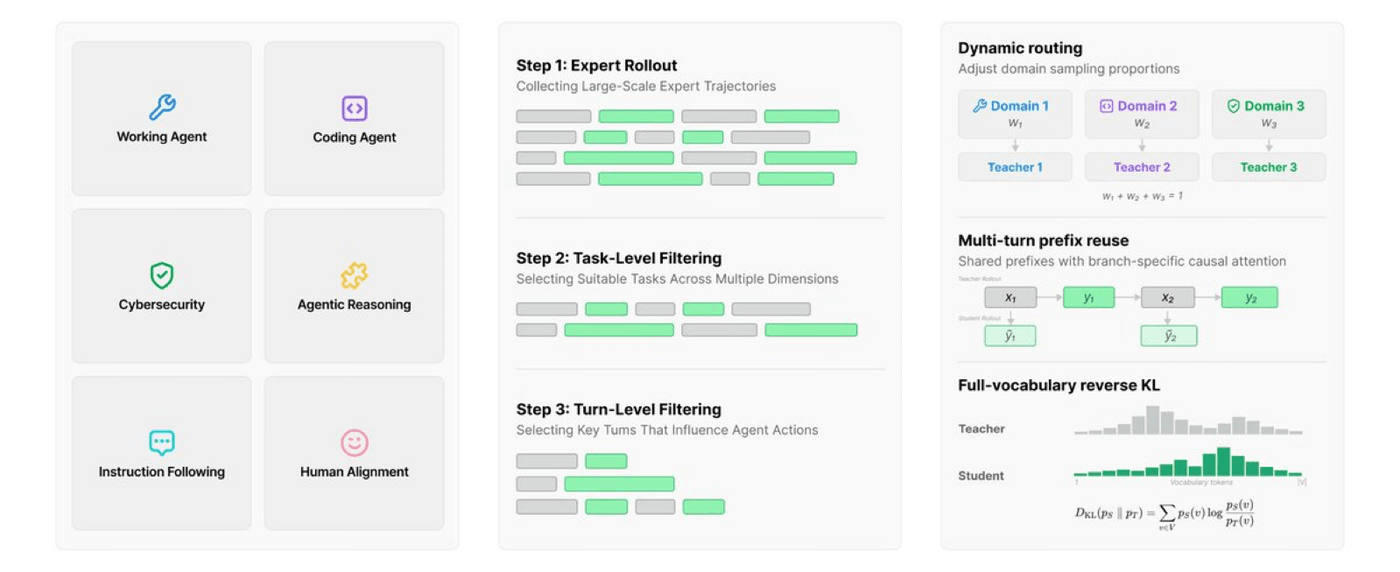 Les groupes d'experts, le filtrage des trajectoires et la distillation de LongCat-2.5, tirés de l'article de Meituan.
- Données et environnements : un pipeline de synthèse filtre les pull requests GitHub et les issues associées, fait annoter les tâches et construire les environnements par des agents, puis les valide avec des tests fail-to-pass et pass-to-pass. Des tâches de code internes réelles élargissent la couverture, et les trajectoires d'échec d'agents en conditions réelles deviennent des tâches d'entraînement reproductibles et vérifiables.
- RL asynchrone : rollouts partiels avec suréchantillonnage, filtrage des groupes dont tous les rollouts réussissent ou échouent, et écrêtage et remise à l'échelle pour limiter le biais des tokens périmés générés par d'anciens checkpoints.
- Détournement de la récompense : les environnements de tâches n'ont aucun accès au réseau ni historique git ni fichiers en cache, un juge LLM audite les trajectoires à la recherche d'exploits, des pénalités freinent les raisonnements et les appels d'outils répétés, et la récompense est redistribuée entre les échantillons positifs pour contrer l'allongement des réponses.
- Entraînement mixte : des tâches alignées sur différents benchmarks sont mélangées avec leurs scaffolds dans des proportions variables, et Meituan indique que les gains d'une tâche à l'autre se renforcent mutuellement.
- Distillation multi-enseignants (MOPD) : le modèle conserve les groupes d'experts de LongCat-2.0 pour les capacités d'agent, de raisonnement et d'interaction. L'étudiant échantillonne en ligne dans plusieurs domaines et est entraîné par une divergence KL inverse sur le vocabulaire complet. Des préfixes par coupure et des rollouts d'étudiant plafonnés par segment stabilisent les longues réponses, tandis que le prefill partagé, la réutilisation du cache KV et Tree Attention maintiennent un coût faible pour l'échantillonnage et l'entraînement.
Infrastructure
Meituan entraîne de longues séquences sur des accélérateurs d'IA nationaux disposant chacun de moins de 80 Go de mémoire, en alignant le parallélisme sur la topologie du supernode. Son FSDP à double partition atteint un débit par appareil supérieur de 86 % à une base DDP lors d'un SFT sur longues séquences. Meituan rapporte aussi des log-probabilités par token identiques bit à bit entre l'entraînement et l'inférence malgré un parallélisme différent, ainsi qu'un prefill et un decode désagrégés pour les rollouts à long contexte, où un ratio prefill/decode de 3:2 a donné les meilleurs résultats lors de son test.
Pour l'inférence, Meituan a conçu une solution W4A4 qui quantifie les poids et les activations des experts sur 4 bits grâce à des unités INT4 natives, avec une précision qui, selon lui, égale celle du modèle non quantifié sur toutes les tâches aval évaluées. Face à une base W8A8 INT8, les tests de charge en ligne montrent un débit de prefill en hausse de 43,3 %, un débit de decode en hausse de 42,77 %, un temps jusqu'au premier token en baisse de 15,91 %, un temps par token de sortie en baisse de 19,72 % et une accélération moyenne de 1,73x sur le noyau de grouped-matmul.
Le texte fourni n'indique pas si les poids seront publiés ni sous quelle licence.