
SenseTime a présenté SenseNova-Loop-9B-Preview, « désormais open source », avec pour argument « faire évoluer la profondeur de calcul, pas seulement la taille du modèle ». Le code et les poids sont disponibles dans le dépôt SenseNova-Loop. Il s'agit d'un modèle de langage multimodal destiné aux travaux à long contexte et agentiques, qui prend en entrée du texte et des images et génère du texte, et couvre la compréhension de documents, le code et l'interaction avec des outils externes.
Ce que revendique SenseTime
- Performances de classe 27B : le modèle de 9B « offre des performances de classe 27B sur les tâches complexes » et devance Qwen3.5-27B sur WorkBuddy Bench, RaccoonPPT Bench et AutomationBench.
- Gains du mHC : les hyper-connexions à contrainte de variété font progresser les scores de 4,42 points sur GPQA Diamond et de 13,34 sur TeamBench.
- Cas d'usage : de bons résultats en code, en bureautique et sur les tâches d'agent, y compris des démos HTML interactives et animées.
- Suite : des modèles plus grands, une réflexion adaptative rapide et lente, et un raisonnement plus efficace.
Comment fonctionne la boucle
Le décodeur compte 32 couches distinctes. Les couches 0 à 3 s'exécutent en premier, puis le bloc des couches 4 à 27 (24 couches) est appliqué deux fois de suite avec les mêmes poids, avant les couches 28 à 31 et la tête de sortie. Cela représente 56 calculs de couches de décodeur par passe avant, pour seulement 32 couches de poids stockées : un chemin plus profond sans dupliquer les paramètres du bloc répété.
- mHC à deux flux : dans la section bouclée, des applications apprises contrôlent la manière dont chaque couche lit à partir de deux flux résiduels, les mélange et réécrit sa sortie. Une normalisation de Sinkhorn contraint l'application de mélange des flux, avec 20 itérations dans la configuration documentée.
- Attention hybride : chaque groupe de quatre couches comprend trois couches d'attention linéaire et une couche d'attention complète, et les bornes de la boucle s'alignent sur des groupes entiers, de sorte que le motif se conserve sur les deux passes.
- Configuration d'exécution : la plage de la boucle, le nombre de passes et le routage du mHC font partie du checkpoint ; une implémentation d'inférence doit donc les charger et reproduire l'ordre d'exécution.
- Entraînement : les recettes documentées combinent séquences longues, images, code et trajectoires de tâches supervisées, jusqu'à 262 144 tokens.
- Accélérations : le modèle prend en charge la prédiction multi-token (MTP). DSpark et DFlash2 sont en développement, avec un entraînement en cours. SenseTime indique que les gains de vitesse concrets dépendent de la charge de travail, du matériel et de la configuration de service.
Les graphiques de benchmarks
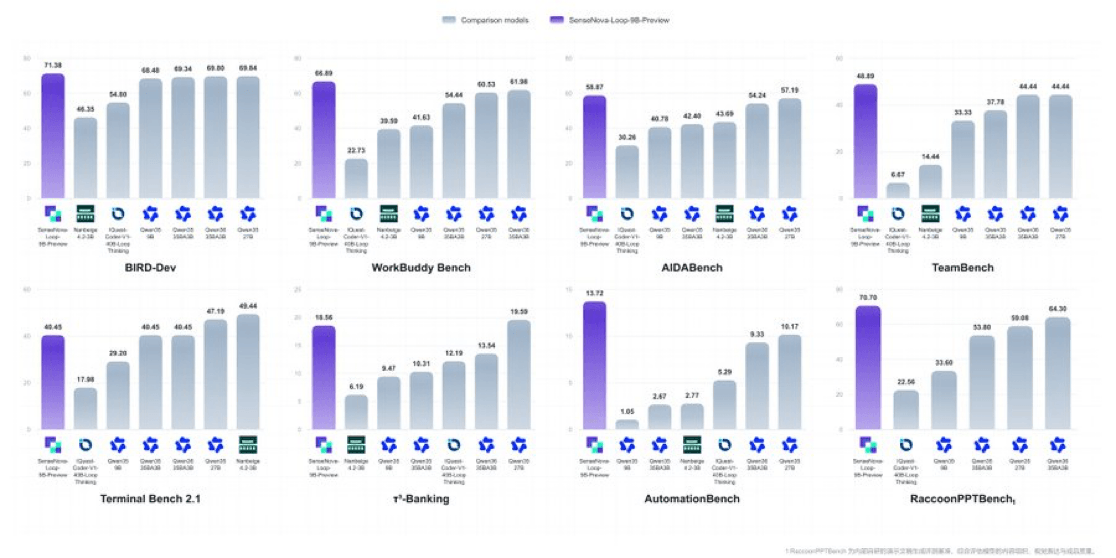 Graphiques comparatifs de SenseTime pour SenseNova-Loop-9B-Preview, issus de son annonce.
SenseNova-Loop-9B-Preview obtient le meilleur score parmi les modèles présentés sur six des huit graphiques : BIRD-Dev (71,38), WorkBuddy Bench (66,89), AIDABench (58,87), TeamBench (48,89), AutomationBench (13,72) et RaccoonPPTBench (70,70). Il se place derrière sur Terminal Bench 2.1, où il obtient 40,45 contre 47,19 et 49,44 pour les deux meilleurs, et sur tau-cubed Banking, avec 18,56 contre 19,59 pour le modèle en tête. L'ensemble de comparaison est constitué de petits modèles : iQuest-Coder-V1-40B-Loop-Thinking, Nanbeige4.2-3B, Qwen3.5 en 9B, 35B-A3B et 27B, et Qwen3.6 35B-A3B. L'écart le plus large concerne RaccoonPPTBench, environ 6 points au-dessus de la barre suivante. Il s'agit des résultats propres à SenseTime, avec des scores lus sur le graphique, et les chiffres de RaccoonPPTBench proviennent d'un benchmark interne.
Il fait suite à d'autres offensives sur les petits modèles ce mois-ci, comme Nanbeige4.3-33B.